





nginx master进程不防杀而重韧性:即使被kill-9或崩溃,worker仍可独立处理请求;核心靠进程隔离、socket继承、systemd兜底及oomscoreadjust等机制保障服务不中断。
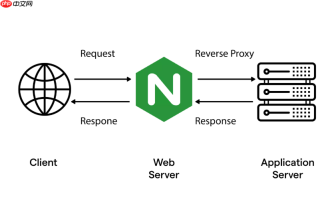
Nginx 的 Master 进程本身不靠“防止被关”来保障稳定,而是通过设计上接受关闭、但确保关闭后服务不中断来实现韧性。它不追求绝对防杀,而是让哪怕被 kill -9、OOM 杀掉或意外崩溃,也不导致整个服务不可用。
用进程模型隔离风险
Master 只负责管理,不处理请求。Worker 才是真正干活的。只要 Worker 还在运行,服务就还在响应——哪怕 Master 消失了:
- 启用 master_process on(默认即开启),禁用该指令会让 Nginx 退化为单进程,一杀全断,且失去所有恢复能力
- Worker 进程由 Master fork 启动,监听 socket 在 fork 前已创建并保持打开;即使 Master 崩溃,已有 Worker 仍能继续收发请求
- 容器部署时加 --init(如 tini),让 PID 1 能自动回收孤儿进程,避免 Worker 因 Master 挂掉而变成真正的孤儿
加固信号处理链路
多数“异常关闭”其实是信号误发。关键不是拦住信号,而是让信号触发可控行为:

- 禁止对 Master 直接使用 kill -9;生产环境统一走 systemctl stop nginx 或 nginx -s quit,这些会走预设的优雅退出流程
- Master 收到 SIGTERM 后,会向 Worker 发送 SIGQUIT,Worker 处理完当前请求再退出,不丢连接
- 在 systemd service 文件中设置 KillMode=control-group,确保主进程退出时整组进程被一并终止,避免残留 Worker 卡死
操作系统层兜底防护
把 Master 的存活优先级调高一点,降低被系统机制误杀的概率:
- 在 systemd unit 文件中配置 OOMScoreAdjust=-500,降低 OOM Killer 选中 Master 的倾向(不设 -1000,避免影响系统稳定性)
- 设置 Restart=always 和 RestartSec=5,确保 Master 异常退出后 systemd 能自动拉起新实例(注意:这不能替代 Worker 自治,只是补位)
- 确保 worker_processes auto 或合理固定数值,使 Worker 数量匹配 CPU 核心数,避免因资源争抢引发连锁崩溃
上线前做崩溃耐受验证
别等线上出事才试。定期模拟最坏情况:
- 手动 kill -9 $(cat /var/run/nginx.pid) 干掉 Master
- 立刻执行 ps -eo pid,ppid,comm | awk '$2==1',确认没有 Worker 的 PPID 变成 1(即没变孤儿)
- 用 curl -I http://127.0.0.1 验证服务是否仍在响应;观察 error.log 是否出现 worker 异常重启记录


