





1、 null
2、 原理如下所述
3、 二者作用机制存在本质区别。过拟合的根源在于模型对任务的建模能力过强、表达形式过于冗余,因此缓解策略的核心在于适度降低模型的表征复杂度,使其更契合问题本身的内在规律。
4、 BN通过构建更为平滑的优化地形来引导训练过程,强调参数更新路径的稳定性与连续性,其基本假设是:解空间越平滑,模型的泛化性能越可靠;而Dropout则致力于增强模型对结构扰动的容忍能力,要求网络在部分神经元失效时仍能保持输出一致性,其理论依据在于:具备强鲁棒性的解往往天然具备良好的泛化潜力。尽管实现路径各异,但最终目标高度统一。
5、 就抑制过拟合的作用方式而言,Dropout的方式更为显性、直观且操作层面较粗粒度;BN的影响则更为隐性,但它深入到训练动力学层面,触及梯度传播与参数收敛的根本稳定性。二者机制既有明显分野,也存在潜在协同,平滑性与鲁棒性虽常正相关,但并非严格等价,故不宜简单判定优劣。
6、 从理论基础看,BN在统计学习框架下具备更强的合理性支撑,理想状态下应能更有效地提升模型泛化性能。然而,受限于其实现方式——仅依赖特定层内统计量进行归一化,缺乏对整体分布动态变化的充分建模,导致其平滑性约束不够完备,因而在实际任务中对泛化能力的增益往往不及理论预期显著。

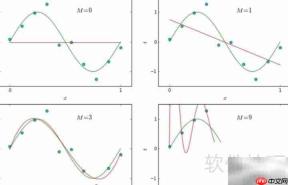
7、 过拟合表现为模型参数规模过大、结构过于复杂,致使模型在训练集上拟合过度,却在测试集或新样本上预测精度大幅下降。
8、 Dropout借助随机屏蔽部分神经元的方式,有效削弱了网络单元间的共适应现象,从而降低了整体模型复杂度,缓解过拟合趋势。
9、 批归一化(Batch Normalization)的主要设计目标是加快模型收敛速度并缓解梯度爆炸/消失问题。若将其视为一种正则化手段,则其潜在泛化收益主要源于归一化过程中引入的微小随机性——该噪声效应类似于轻量级数据增强,在每批次输入上施加细微扰动,间接提升了模型对输入变化的适应能力。





