





克雷西 发自 凹非寺量子位 | 公众号 qbitai
DSpark开源仅一周,便成功登陆苹果设备。
该移植版本命名为mlx-dspark,当前已适配Gemma-4 12B与Qwen3-4B两款主流模型。
部署后,二者在Mac平台上的推理速度分别提升至原来的1.6倍与1.4倍。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
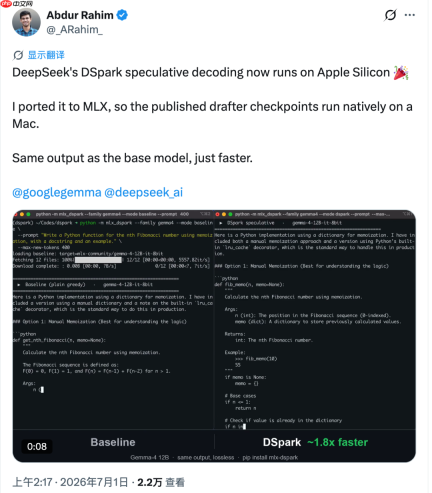
尤为难得的是,它实现了绝大多数本地化移植方案难以达成的目标——输出结果与原始模型严格逐字节一致,零偏差、零失真。
换言之,提速的同时,精度毫发无损。
项目开发者Abdur Rahim是一名热衷开源实践的工程师,利用业余时间独立完成了DSpark首个苹果芯片原生版本的全部开发工作。
苹果设备跑大模型,实测提速60%
DeepSeek于6月27日正式开源DSpark框架,官方数据显示其在服务端GPU环境可实现60%–85%的单用户生成加速。
但初始版本仅支持数据中心级GPU,尚未覆盖Apple Silicon生态。
mlx-dspark正是这一技术首次面向苹果芯片的完整落地实现。
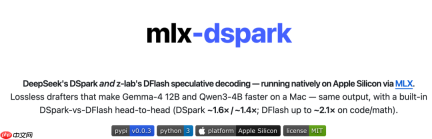
DSpark的核心机制是引入轻量级“草稿模型”辅助主模型推理:草稿模型并行生成多个候选token序列,主模型一次性验证并筛选有效片段,正确则采纳,错误则丢弃重试。
然而,该验证环节在不同硬件平台的成本差异显著。
在数据中心GPU上,批量验证近似“包车计费”——无论验证5个还是15个token,开销基本恒定;解码瓶颈主要在于显存带宽,额外计算几乎不增加延迟。
而在苹果芯片上,验证过程更像“打表计程”——每多验证一个token,耗时线性增长。
Rahim实测发现,Gemma-4 12B在M4 Pro上每多验证一个token平均需额外消耗约14毫秒。据此构建成本模型后,他推算出苹果平台理论加速上限约为2.2倍。
最终,他将HuggingFace开源的草稿模型checkpoint适配接入,并为Gemma-4 12B与Qwen3-4B分别定制部署;同时在MLX框架内重构验证流程,并将权重统一量化为4-bit。
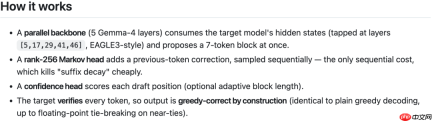
实测结果显示:在M4 Pro设备上,相较于苹果官方MLX工具链,Gemma-4 12B解码速率由18.4 tok/s跃升至约30 tok/s(+1.6×);Qwen3-4B则从52.9 tok/s提升至约73 tok/s(+1.4×)。
此外,mlx-dspark还完成了一项多数本地移植未触及的关键突破:
高保真采样还原,不止于贪婪解码
常规本地部署通常仅支持贪婪解码(greedy decoding),即每步仅选取概率最高的token,虽简单高效,却牺牲了生成多样性与分布保真度。
Rahim在mlx-dspark中完整复现了DSpark论文提出的温度采样逻辑:草稿模型输出候选序列后,接受概率按min(1, p/q)计算,未通过部分由残差分布重新采样。
他亲自比对验证,在相同温度参数下,mlx-dspark输出的概率分布与原始模型完全一致,非近似、无衰减。
多数投机解码实现止步于贪婪模式,因其验证方式直观——只需逐字比对即可确认正确性。

Qwen 视频智能分析基础客户端(免费版),基于 Qwen 3.5 Plus 多模态模型对本地视频进行内容分析,支持场景描述与基础内容理解,采用默认抽帧频率和提示词,适合快速概览视频,API Key 读取自 ~/.skill-platform/skill-platform.json 的 skills 配置。
而Rahim额外投入精力,对采样路径下的整套输出分布进行了全量校验,确保统计特性精准复现。
他还深入调试了目标模型精度配置这一关键细节:
若草稿模型搭配未经指令微调的基础版主模型,候选token平均通过率仅为47%;切换为对应指令微调版本后,该指标跃升至82%。
进一步测试表明,将主模型升级为bf16精度虽提升通过率,但验证开销增幅更大,整体反而拖慢推理——因此默认采用8-bit精度成为最优解。
至于负责预生成的草稿模型,Rahim同样做了精细化压缩:4-bit量化后体积仅1.8GB,内存加载无压力,且全程保持无损推理能力。
最终效果是,DSpark不仅达成加速目标,更在终端设备上真实复现了论文所述16%–18%的平均接受长度提升。
DFlash同步集成,代码任务再提速
推文发布后,评论区收到一条来自DFlash作者Jian Chen的留言:“能否尝试接入我们的模型?”
DFlash由z-lab团队于今年5月提出,核心作者Zhijian Liu系UCSD助理教授兼NVIDIA研究科学家。
其技术路线与DSpark存在本质差异:DFlash采用“块扩散”策略,一次并行去噪整块16个token,而非DSpark式的依赖建模式渐进猜测。
Rahim迅速响应,借助Jian提供的移植脚本,将z-lab发布的gemma4-12B-it-DFlash模型接入mlx-vlm中的Gemma-4主干,并在同一台Mac设备上与刚完成测试的DSpark展开横向对比。
在代码与数学类任务中,DFlash的块级接受长度达5.95–6.20,解码速率达约36 tok/s,提速约2.1倍,小幅领先DSpark。
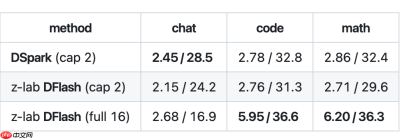
但DFlash存在明显场景局限:其固定16-token块结构在开放域对话等不可预测任务中表现乏力——因主模型往往只接受其中部分token,“接受长度”下降,块填充率不足,优势难以释放。
DSpark所采用的Markov head机制,正是为解决此类问题而设计:它在并行生成基础上引入token间依赖建模,动态修正后续位置间的语义一致性,显著缓解“块内脱节”现象。
因此,在自由对话场景中,DSpark反超DFlash,展现出更强泛化能力。
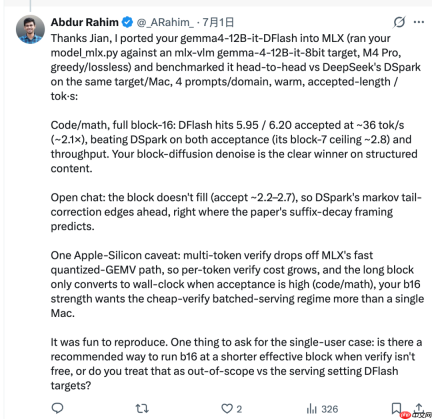
最新发布的mlx-dspark v0.0.3版本已正式整合z-lab原版DFlash,并新增可调参数,支持手动设置DFlash的有效块长度:聊天场景启用短块(如4–8 token),保障响应流畅性;代码与数学任务则维持满16-token块,最大化吞吐效率。
至此,同一套工具包即可无缝兼顾多类任务,无需在DSpark与DFlash之间反复切换部署。
Rahim在社交平台透露,该方法论同样适用于更大规模的Qwen3-8B与Qwen3-14B草稿模型,后续适配已在推进中。
参考链接:[1]https://www.php.cn/link/bacea30d16b0bb49c20bbd59106591e4
本文来自微信公众号“量子位”,作者:关注前沿科技,36氪经授权发布。



