





nginx worker process 本身不实现限流逻辑,限流由显式配置的 limit_req 或 limit_conn 模块在请求处理链路中触发;worker 仅执行指令,依据配置返回 503 或 429,而非自动智能决策。
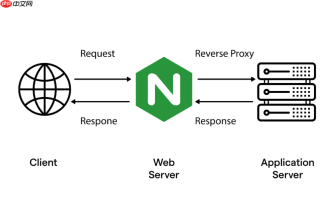
Nginx 的 Worker Process 本身不实现响应限流逻辑,它不主动判断“该不该限流”或“要不要降速”。限流不是 worker 的内置行为,而是由你显式配置的模块(如 limit_req、limit_conn)在请求处理流程中触发的策略动作。
真正起作用的是配置,不是 worker 自身的智能决策。
限流发生在请求处理链路中,而非 worker 进程内部
当一个请求到达 worker 进程后,Nginx 按照配置顺序执行处理阶段:
→ 解析请求 → 匹配 location → 执行 limit_req 或 limit_conn 检查 → 决定放行或拒绝
这个检查过程由对应模块完成,worker 只是执行指令。如果触发限流,worker 会立即返回 503 Service Temporarily Unavailable(或你自定义的 429 Too Many Requests),不转发给后端,也不排队等待。
Worker 被动“表现像限流”,其实是资源耗尽的结果
worker 不会因为 CPU 高、负载大就自动变慢或拒接请求。但它在以下真实瓶颈下,会间接导致请求失败,看起来像“系统级限流”:
- 文件描述符用尽(
ulimit -n达上限)→accept()失败,新连接被内核丢弃 -
worker_connections设得太小 → 达到上限后不再 accept 新连接 - 上游响应极慢(如
proxy_read_timeout过长)→ worker 线程长期阻塞,可用 worker 数减少,新请求排队或超时 - 共享内存区(如
limit_req_zone)空间不足 → 旧条目被强制淘汰,影响统计精度
这些都不是“限流策略”,而是系统过载后的自然降级。
你必须手动配置才能真正限流
有效限流依赖两个核心模块的显式启用:

-
limit_req(按速率)- 基于漏桶算法,控制单位时间请求数
- 必须先定义
limit_req_zone(共享内存 + key + rate) - 在
location中用limit_req zone=xxx burst=20 nodelay启用 - 示例:
limit_req zone=login burst=5 nodelay;表示每个 IP 登录接口最多瞬时 5 次,超即返 503
-
limit_conn(按连接数)- 控制并发 TCP 连接数,适合防下载打满带宽或长连接耗尽资源
- 使用
limit_conn_zone+limit_conn,key 可为$binary_remote_addr或$server_name - 注意:它统计的是活跃连接,不是请求数;受
keepalive设置直接影响
两者都依赖共享内存(zone=),因此能在多个 worker 间协同计数,避免单 worker 局部失效。
配合系统层,才能让限流稳得住
Nginx 配置只是上层策略,底层需操作系统支持:
- 调大
net.core.somaxconn和net.core.netdev_max_backlog,防止内核连接队列溢出 - 启用
tcp_tw_reuse,加快 TIME_WAIT 回收,缓解端口耗尽 - 用
systemd或 cgroup 限制 Nginx 整体内存,避免 OOM killer 杀 worker -
worker_rlimit_nofile应与ulimit -n对齐,确保 worker 能打开足够文件描述符
没有这些,再精细的 limit_req 配置也可能在高并发下被绕过或失效。
不复杂但容易忽略


