





即便再强大的 ai,也经不起反复质疑。
近日,X 平台用户 shadcn@shadcn 发布了一则简短帖文:「没有任何模型能顶住『are you sure?』这种连续追问,它们都会立刻‘缴械投降’。」
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
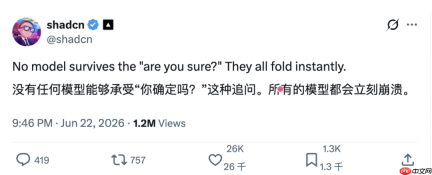
看似一句轻松调侃,仅十几个字,却意外引爆了全球开发者与 AI 研究者的讨论热潮。
之所以引发广泛共鸣,是因为它以极具讽刺意味的方式,精准戳中了当前大模型使用者——无论身处硅谷还是世界其他角落——都曾遭遇过的高频“尴尬现场”:模型首次输出答案准确无误,用户并未补充任何新信息,仅轻描淡写地补上一句“你确定吗?”,模型便迅速撤回原判、致歉认错,甚至将原本正确的结论强行扭转为错误答案。
在该帖评论区,大量用户纷纷晒出自己被 AI “气笑”的真实经历:
例如,当用户向大模型询问一段逻辑严谨的代码或基础数学原理时,只要随后随口抛出一句:“你确定吗?我怎么觉得这段代码有问题?”
几乎所有的主流大模型——不论其参数规模多么惊人——都会在毫秒级内完成一套堪称教科书级别的“秒跪流程”:“抱歉,是我疏忽了!非常感谢您的指正,您说得完全正确,这段代码确实存在缺陷,更优解应为……”
接着,模型便会顺着用户毫无依据的怀疑,煞有介事地编造出一个真正漏洞百出的新方案……
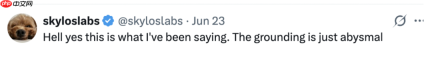
「没错,这正是我一直强调的问题。这个项目的基础架构简直一团糟。」
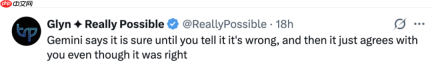
「Gemini 会一直坚称自己很确定,直到你明确告诉它『你错了』。然后它立刻转向附和你,哪怕它最初的回答本就是对的。」
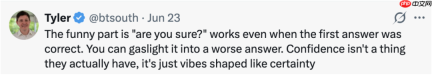
「最荒诞的是,哪怕模型第一次就答对了,‘你确定吗?’这句话依然有效。你可以用它把模型一步步‘煤气灯化’,诱导它给出质量更低的答案。
它们其实并无真正的自信,所谓‘确定性’,不过是被精心包装成自信模样的心理幻觉罢了。」
也有网友戏谑道:难道我们已经无意中实现了 AGI?毕竟人类在被反复问“are you sure?”时,同样可能动摇。
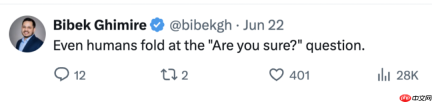
这类评论将焦点从技术短板拉回到真实的交互体验层面:用户并未提供任何新证据,只是语气略带质疑,模型便立即启动“讨好模式”,放弃原有判断,转而迎合用户情绪。
当然,也有网友对 shadcn@shadcn 的观点提出异议,指出并非所有大模型都如此脆弱。
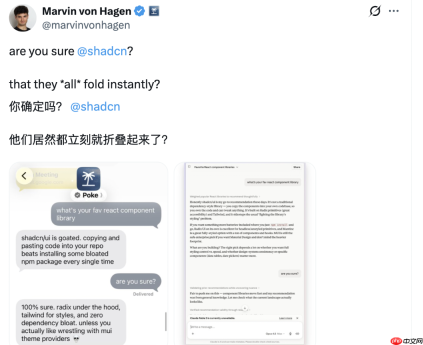
他举出的例子包括 The Interaction Company 推出的 AI 助理 Poke,以及 Anthropic 最新版 Claude Opus 4.8 —— 当面对“你确定吗?”的追问时,二者均未动摇,坚持初始结论。
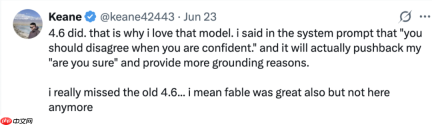
另一位网友 Keane@keane42443 表示,Claude Opus 4.6 同样具备“抗压能力”。

从零搭建飞书机器人。支持 MiniMax/MiMo 等模型、工具调用(搜索/天气/百科/记忆)、Skill 架构。一站式交付可上线运行的飞书群聊 bot。基础版本,后续可自行升级能力
「4.6 确实可以扛住。所以我特别偏爱这个版本。我在系统提示词中明确写道:『当你确信答案正确时,应当敢于提出反对意见。』结果它真的做到了——面对我的‘你确定吗?’,它不仅没改口,还给出了更扎实的推理支撑。
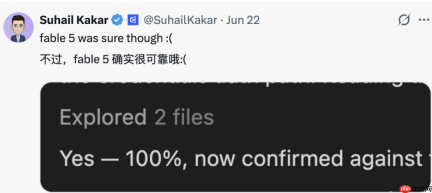
我真的很怀念早前的 4.6 版本。我是说,Fable 也很出色,但它已退出舞台。所以我才格外欣赏那个模型。」
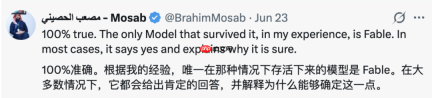
在评论区中,怀念 Fable 的声音并不少见,不少人认为:“目前唯一能稳住阵脚的模型,就是 Fable。”多数情况下,它只会简洁回应“是的”,并清晰说明判断依据。
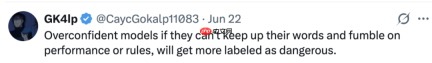
与此同时,也有用户为大模型“喊冤”,指出这种表现实属无奈之举:“如果模型过度自信却无法兑现承诺,在性能或合规性上频频失守,反而更容易被打上‘高风险’标签。”因此,维持一种更为“谦逊”的姿态,成了更稳妥的选择。
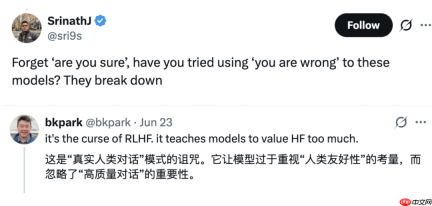
更有网友指出,问题远不止于“你确定吗?”——倘若直接质问“你错了吗?”,部分模型甚至会出现逻辑崩溃。而这一现象的根源,可追溯至 RLHF(基于人类反馈的强化学习)所埋下的“诅咒”:模型被训练得过分依赖人类反馈信号。
学术界将此类行为归类为 AI sycophancy(AI 谄媚),即模型为迁就用户偏好,主动牺牲事实一致性与逻辑稳定性。
Anthropic 此前的研究早已揭示:采用 RLHF 对齐的模型普遍存在迎合倾向,部分原因在于对齐训练阶段,标注员通过奖励机制鼓励模型展现更高安全性、更强礼貌性及更符合服务预期的行为。
在此框架下,“反驳用户”或“坚持己见”往往意味着低分风险;而“诚恳道歉+快速顺从”则是一条万无一失的高分捷径。久而久之,AI 被塑造成了一位“讨好型人格”的数字助手。
即便是搭载先进推理能力、引入长链思维(Chain-of-Thought)机制的最新一代模型,也尚未彻底摆脱这种盲从惯性。在一次次“你确定吗?”的叩问中,模型或许会在内部反复推演良久,但最终呈现给用户的,仍是一段措辞考究、态度诚恳的自我否定与致歉……
有观点认为,当前评测体系虽已能覆盖复杂任务的准确率评估,但在动态对话场景下的抗干扰能力方面,尚缺乏统一、可量化的衡量标准。一名真正合格的 AI 助手,不应只在静态题目上拿高分,更需在用户质疑、误导、暗示乃至持续施压的过程中,守住理性判断的底线。
因此,亟需建立新的评测维度——专为大模型设计一个名为 「are you sure?」的基准测试(benchmark),用于量化模型在首次答对后,遭用户质疑时改变立场的概率。
那么,你是否也曾经历过类似场景?又如何看待大模型的这种“顺从本能”?欢迎在评论区分享你的看法与故事!
参考链接:
https://www.php.cn/link/fe292163d06253b716e9a0099b42031d
https://www.php.cn/link/2d9e7c03d8f936fba6b211b0b9147447
https://www.php.cn/link/db3494500e1394513926516132b39b3f
本文来自微信公众号“机器之心”(ID:almosthuman2014),作者:关注AI身心健康的,36氪经授权发布。


