





掌握现代nginx运行底座的关键在于理解请求生命周期如何被事件驱动模型、进程协作机制和配置分层逻辑共同塑造,而非堆砌参数;工业级转发拓扑的弹性与可维护性源于对这三者的精准控制。
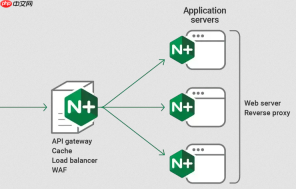
掌握现代 Nginx 运行底座,关键不在堆参数,而在理解“请求生命周期”如何被事件驱动模型、进程协作机制和配置分层逻辑共同塑造。工业级转发拓扑的弹性与可维护性,来自对这三者的精准控制,而非功能罗列。
吃透 master-worker 与事件循环的真实分工
很多人把 worker_processes 设成 auto 就以为“自动优化”了,其实这是个陷阱。Nginx 的弹性起点是让每个 worker 进程真正独占一个 CPU 核心,避免上下文切换损耗。worker_rlimit_nofile 必须显式设为 65536 或更高,否则连接数刚到万级就卡在文件描述符耗尽;而 events 块里的 use epoll(Linux)不能省略——它决定了内核通知你哪个 socket 就绪,而不是轮询所有连接。
- worker_processes 应等于物理 CPU 核心数,禁用超线程干扰(如 8 核服务器设为 8,不设 16)
- 每个 worker 的最大连接数 = worker_connections × worker_processes,这个值要匹配系统 ulimit -n 和 net.core.somaxconn
- 启用 accept_mutex on 可减少惊群效应;multi_accept on 允许单次事件处理多个新连接,提升吞吐
用配置分层约束拓扑复杂度
工业级拓扑不是靠 location 嵌套越深越“高级”,而是靠 main → http → upstream → server → location 的层级隔离实现可演进性。比如:upstream 定义必须独立于业务逻辑,只管后端地址、健康检查与权重;server 块只负责协议入口(HTTP/HTTPS)、域名路由与 TLS 终结;location 则专注路径语义(/api/v1 → proxy_pass,/static → alias + expires)。

- 把所有 upstream 集群统一放在 /etc/nginx/conf.d/upstreams.conf,禁止在 server 块里 inline 定义
- SSL 证书、密钥、OCSP stapling 等 TLS 相关配置抽离到单独的 ssl_params.conf,通过 include 复用
- 每个业务域(如支付、用户中心)用独立的 server 块文件,命名带环境标识(payment-prod.conf),便于灰度发布
让健康检查与故障转移真正“可观察、可干预”
proxy_next_upstream 默认只重试 500/502/503/504,但真实业务中可能需要重试超时或上游返回特定错误码(如 429)。被动检查不够,必须搭配主动健康检查:upstream 内用 health_check interval=3 fails=3 passes=2 指令,探测路径用 /healthz 这类轻量接口,不走主业务链路。
- fail_timeout=10s 表示节点失败后 10 秒内不调度,不是“永久剔除”,避免误判
- backup 节点仅在所有主节点不可用时启用,但需配合 max_fails=0 防止 backup 自身也被标记失败
- 用 stub_status 模块暴露 nginx 连接状态,并接入 Prometheus,监控 active、reading、writing、waiting 四个指标的分布突变
用 GitOps+原子化 reload 控制变更风险
reload 不等于零中断——如果 upstream 后端列表变化,旧连接仍会打到已下线节点,直到自然断开。真正的高可维护性来自变更闭环:每次配置提交都触发 CI 流水线,先运行 nginx -t 验证语法,再用 diff 对比线上 vs 新配置,最后执行 nginx -s reload 前注入 pre-reload hook(如暂停 Consul 服务注册),reload 成功后再恢复。
- 禁止直接编辑线上 nginx.conf,所有变更走 Git 提交 + Ansible 推送
- 使用双版本热备:A/B 组节点错峰 reload,期间 keepalived 权重动态调整,流量平滑迁移
- 配置中加入 include /etc/nginx/conf.d/*.conf.enable,通过软链接开关模块,避免注释/取消注释带来的语法风险


