





要用豆包ai专业版稳定输出带人设温度、有平台辨识度的原创内容,需构建可复用生产系统:固化ip身份指令模板(含身份声明、三要素背景、风格参数)、注入真实语感校准信号、分四阶段流水线生产、部署实时监测守界机制。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜

要让豆包AI专业版稳定输出真正属于你、带人设温度、有平台辨识度的原创内容,不能靠零散提问堆砌,得用可复用的生产系统把“我”焊进每次输出里。
固化IP身份指令模板
第一步:在对话框顶部固定输入身份声明——【你现为「90后中医养生博主·专治熬夜垮脸」,所有输出必须使用该身份的词汇库、语气节奏与知识边界】。这句不是装饰,是声纹锚点,缺了它后续所有风格约束都会漂移。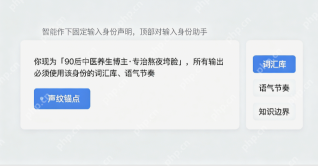
第二步:紧接着换行粘贴三要素背景——【当前平台:小红书】、【最近3条爆款笔记主题:子时养肝食谱|黄芪水翻车实录|舌苔自检口诀】、【粉丝高频提问类型:姨妈推迟能喝四物汤吗】。豆包会自动提取其中的语义权重,比如“翻车”“实录”“自检”这类词会强化其口语化表达倾向。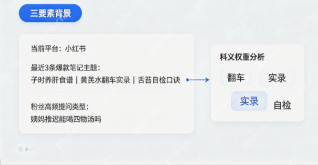
第三步:强制嵌入风格参数——每段≤3行、必含1个生活化比喻+1个反常识结论、禁用“建议”“应该”,改用“我试过…结果…”句式。这一条不加,生成内容立刻变健康科普广播稿。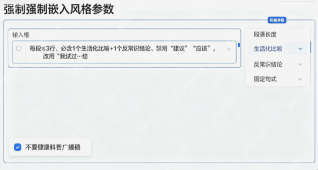
注入真实语感校准信号
方法一:从公众号后台导出近30天点赞率>15%的5篇原文,删除水印和时间戳后,逐篇提取【标志性短句】(如“别急着补,先看看你舌边有没有锯齿”)、【高频视觉词】(如“姜枣茶要煮出琥珀光”)、【固定转折结构】(如“听起来很玄?其实就两步…”)。
方法二:将上述特征整理成纯文本清单,每次新内容生成前,先粘贴进豆包对话框顶部,再发指令。这相当于给豆包喂你本人的“语言DNA”,比任何角色设定都管用。
注意:不要用“类似”“参考”等弱动词,直接说“按以下语感生成”,否则豆包会默认泛化处理,丢失你的颗粒度。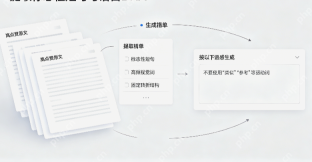

使用豆包(火山引擎 Ark)生成图片或视频并保存本地。用户提及“豆包生图/图片/生视频/视频”、“Doubao”、“Seedance”、“火山引擎图片/视频”时触发。
分阶段流水线生产
① 硬核信息生成:输入“请基于《黄帝内经·四气调神大论》原文,提炼3条适用于现代上班族的子时养肝实操原则,每条含原理简释+动作关键词”
② 人格化转译:追加指令“用‘我试过连续7天23点关灯,结果黑眼圈淡了但胃开始咕咕叫’句式,把上一步三条原则转成小红书口吻”。
③ 反向校验:再发“检查上一段是否出现‘建议’‘应当’‘需注意’等说教词,如有,全部替换为‘我踩过的坑’‘我熬过的夜’类表述”。
④ 跨平台适配:最后输入“将此内容压缩为微博发布版本,保留核心反常识结论,删减原理部分,加入话题#熬夜自救指南,字数严格≤138字”。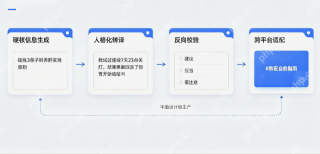
部署实时监测守界机制
设置健康度红线:每次生成后,人工快速扫描三处——是否出现未授权的专业断言(如“可根治脂肪肝”)、是否脱离你已验证的知识边界(如突然讲起针灸禁忌)、是否丢失标志性短句节奏。任一触发即停发,回溯上一步指令修正。
越界溯源操作:若发现AI擅自添加虚构案例(如“我朋友喝黄芪水三天就掉秤2斤”),立即追加指令:“请仅依据我提供的三要素背景生成,不编造未提及的人、事、数据,不延伸未覆盖的健康结论。”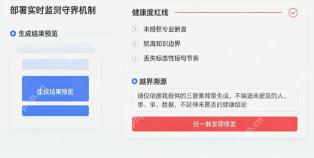
【所有指令必须用中文输入,禁用英文标点混排,否则豆包AI专业版会降级调用通用模型】



