





nginx 无“worker 连接池挂起”概念,“挂起”实为上游通信或客户端交互阻塞所致;keepalive_timeout 仅控制空闲连接保留时长(建议30–60秒),需小于后端超时且大于2倍平均请求耗时,配错会引发502或复用失效。
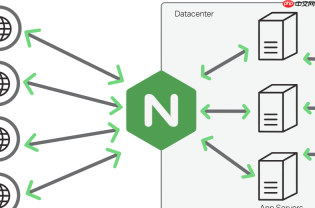
Nginx 本身没有“Worker 连接池挂起”这个概念,也不存在可配置的“Keepalive 超时导致 Worker 挂起”机制。所谓“Worker 挂起”,实际是连接卡在上游通信或客户端交互环节,由超时设置不当、资源耗尽或协议错配引发——不是 Keepalive 超时“导致挂起”,而是它没配对、配错或孤立使用,放大了底层阻塞。
要避免在反向代理配置中因 Keepalive 相关参数误用而加剧连接堆积和响应延迟,关键在于理解三个层级的协同关系:upstream 连接池生命周期、proxy 层协议控制、系统级资源承载能力。单点调参(比如只改 keepalive_timeout)不仅无效,反而容易让问题更隐蔽。
明确 keepalive_timeout 的真实作用
这是 upstream 空闲连接在 Nginx 连接池中保留的秒数,仅影响“复用通道是否还活着”,不控制请求处理时长,也不决定 Worker 是否“卡住”。
- 若设得过大(如 300s),而后端实际空闲超时仅 60s,Nginx 会尝试复用一个已被后端关闭的连接 → 发起请求时直接失败,触发重试或返回 502,看似“挂”,实为连接失效;
- 若设得过小(如 5s),连接频繁进出池子 → 失去复用意义,退化为短连接,CPU 和 TIME_WAIT 反而升高。
建议值:30–60 秒,且必须满足:
- connectionTimeout、Spring Boot 的
server.connection-timeout); 单次请求平均耗时 × 2(留出缓冲,避免刚建立就闲置超时)。

keepalive_requests 不能忽略,它是“主动换血”机制
默认 100 次请求后断连,对现代 API 场景太激进。若后端稳定、请求轻量,设为 500~1000 更合理;若链路含 TLS 或中间 LB(如云 SLB、K8s Service),建议 200~500 —— 它不是“越长越好”,而是防止连接因老化(SSL session 过期、中间设备静默回收、后端滚动更新)变得“看似可用实则失效”。
该参数只在 upstream 块内生效,写在 http/server/location 里无效。
必须配套的协议层配置,缺一不可
keepalive 指令只是物理连接池基础,真正让复用走通,依赖以下三者同时存在:
-
proxy_http_version 1.1;—— HTTP/1.0 不识别 keep-alive,不设此项,Nginx 默认用 1.0 向后端发请求,Connection: close 自动带上; -
proxy_set_header Connection '';—— 清除客户端可能传来的 Connection: close,否则 Nginx 会照转,后端收到后立即断连; - upstream 块内
keepalive N;—— N 是每个 worker 进程维护的空闲连接上限,不是全局总数,也不是每台后端固定数(例如 4 个 worker + 后端单实例最大并发 2000 → N ≈ 2000 × 0.7 ÷ 4 ≈ 35)。
验证是否真复用,别信配置文件
- 压测中执行
ss -tnp | grep :后端端口 | grep ESTAB | wc -l,数值应稳定在keepalive N设定值附近(如设 32,观察值在 28~32 波动),而非随 QPS 线性上涨; -
curl -I http://your-api查看响应头,确认含Connection: keep-alive(来自后端),而非close; - 检查 Nginx error log,高频出现
upstream timed out (110: Connection timed out)或no live upstreams,说明连接池没生效或后端已不可达。
不复杂但容易忽略的是:所谓“挂起”,90% 以上源于 proxy_read_timeout 过长、后端无响应、或连接未真正复用,而不是 keepalive_timeout 本身有问题。


