





每次前沿模型问世,ai圈的目光总会聚焦在几张熟悉的评测成绩单上。
MMLU-Pro、MMMU、MMMU-Pro……这些术语对大众而言略显晦涩,但在模型厂商与学术研究者眼中,它们早已成为衡量能力的“必考科目”。GPT、Claude、Gemini、Llama、Qwen、DeepSeek等主流模型,无一例外都在这些基准上持续提交答卷。
“是骡子是马,牵出来遛一遛”——模型实力如何,往往就靠这些分数来印证。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
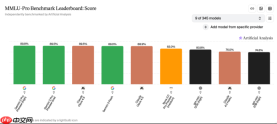
许多新品发布会的性能对比图中,少不了它们的身影;HuggingFace上的权威排行榜,也多以这些评测体系为底层支撑。甚至可以说,当下AI业界谈论模型能力时,所使用的已是一套由这些基准共同塑造的“通用语言”。
但一个耐人寻味的现象是:所有人紧盯分数,却极少追问——题是谁出的?而MMLU-Pro、MMMU与MMMU-Pro这三张关键考卷背后,都清晰浮现着同一个名字:陈文虎。
他是加拿大滑铁卢大学计算机科学系助理教授,谷歌学术引用量逾3万次。
他亦是“老虎实验室(TIGERLab)”的创立者。该实验室英文全称为Text and Image GEnerative Research Lab,因名中带“虎”,他为其赋予了一个极具辨识度的中文昵称——虎头帮。
01
当旧试卷不再奏效
陈文虎首次被广泛认知,源于MMLU-Pro的推出。
MMLU曾是大语言模型评估中最主流的综合性基准之一。它如同一份跨学科综合试卷,覆盖人文、科学、工程等多个领域,用于检验模型在知识掌握与逻辑推理方面的深度。
在发展初期,这张试卷极为有效:模型能力差异能被清晰拉开,行业也能借此追踪技术演进的真实节奏。
然而,问题随之而来。
随着模型能力飞速跃升,MMLU逐渐“失准”。头部模型得分持续逼近天花板,彼此间差距日益模糊。
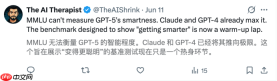
尤其在OpenAI发布o3之后,这一现象愈发突出——o3在MMLU上的准确率已高达近100%,其余先进模型也纷纷交出98%以上的高分。
表面看是喜讯,实则埋下评估危机。
当一张试卷人人都能拿满分,它便失去了区分优劣的能力。它仍可佐证模型已具备基础能力,却难以刻画新一轮突破的方向与程度。
AI产业亟需一份更难、更抗“刷题”、更能反映真实推理水平的新考卷。
2024年,陈文虎团队正式发布MMLU-Pro。
这不是对原题库的简单扩容,而是一次系统性重构。
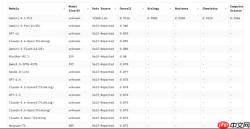
新版本涵盖12032道题目,横跨数学、物理、化学、法律、工程、心理学、健康等14个专业方向;选项由原来的4个增至10个,大幅压缩随机猜测的得分空间;同时剔除大量低区分度、语义模糊或偏记忆型的旧题,代之以更高阶的推理类题目。
效果立竿见影。
论文数据显示,各模型在MMLU-Pro上的平均准确率较原版MMLU下降16%–33%;同一模型在24种不同提示模板下的表现波动,也从原MMLU的4%–5%,收窄至约2%。
换言之,这张新试卷不仅难度跃升,稳定性亦显著增强。
它让那些在旧体系下“齐头并进”的模型,重新显现出能力断层——是真正理解并推理,还是仅擅长应对套路化考题,答案一目了然。
02
真正好用的评测基准
MMLU-Pro迅速被工业界采纳。
它入选NeurIPS 2024数据集与基准评测赛道,并被EleutherAI主流评测框架lm-evaluation-harness集成。对开源社区而言,这意味着它已脱离论文纸面,正式进入开发者日常工具链。
越来越多模型在发布时主动披露MMLU-Pro成绩;HuggingFace多个权威榜单也将其纳入核心评估维度。
如果说MMLU-Pro回应了语言模型评估中的“旧卷失效”困境,那么MMMU则将陈文虎与TIGERLab推至多模态评测的核心舞台。
多模态模型的挑战更为复杂。

纯语言模型只需处理文本;而多模态模型必须协同解析图像、图表、示意图、地图、表格、乐谱、分子结构式等多种视觉信息,在图文交织中完成理解、关联与推理。
MMMU评测集包含1.15万道真实多模态题目,来源涵盖高校考试、教材习题及专业测验,覆盖艺术与设计、商业、自然科学、健康与医学、人文社科、工程技术六大主类,并细分为30个学科、183个子领域。
这些题目并非简单询问“图中有什么”,而是要求模型像专业学生一样,将图像细节与学科知识深度融合,进行判断与推演。
MMMU发布之初,团队对14个主流开源多模态模型及GPT-4V、Gemini Ultra等闭源旗舰进行了测试。即便是当时最强的闭源模型,GPT-4V与Gemini Ultra的准确率也仅为56%和59%。
这组数字揭示了一个现实:尽管多模态模型进步神速,但在需要专业级图文联合推理的任务上,仍有巨大提升空间。
此后,陈文虎团队进一步升级MMMU-Pro,着力封堵模型绕过视觉输入的路径。它筛除所有仅凭文本即可作答的题目,扩大干扰项数量,并引入vision-only设定——将完整题干嵌入图像内,强制模型先完成视觉识别,再结合文本语义作答。
简言之,杜绝“光读文字猜答案”。
这类工作看似琐碎,却至关重要。因为多模态模型未来将深入医疗诊断、教育辅导、科研分析、工业设计、工程建模等关键场景,仅能描述图片远远不够。它必须能判别、能归因、能解释,更需在海量杂乱视觉信息中精准提取关键线索。
03
藏在“考卷”之后的人
陈文虎投身MMLU-Pro与MMMU的开发,并非偶然转向,而是其长期研究脉络的自然延伸。
他的核心关切始终围绕复杂信息理解、知识驱动问答与结构化推理。
他本科就读于华中科技大学,硕士赴德国亚琛工业大学深造,博士毕业于加州大学圣巴巴拉分校计算机科学系。求学期间,他已深耕复杂问答、表格推理、知识证据定位等方向。
这些任务共有的难点在于:答案通常不藏于单一文本之中。
它可能隐于一张数据表,也可能需融合一段文字与一幅插图,甚至要求模型先行检索、再整合、计算、推理。模型不能止步于复述已有知识。
HybridQA、TabFact、Program-of-Thoughts、MAmmoTH等代表性项目,均出自他参与或主导的研究序列。
这也解释了他为何对评估体系中的“漏洞”格外敏锐。
一份优秀的基准,绝非单纯堆砌难题,而在于预判模型最容易“蒙混过关”的环节。
模型可能背熟题库,可能靠选项概率投机,也可能借文字描述绕开图像理解……真正稳健的评测,必须提前封堵这些捷径。
博士毕业后,陈文虎加入谷歌研究院,并于2021–2025年间深度参与谷歌DeepMind Gemini系列多模态模型的研发与评估工作。这段经历尤为关键——长期置身最前沿模型的构建现场,使他更清楚能力增长的路径与瓶颈,也更易识别评估盲区与偏差。
2022年秋,他加盟滑铁卢大学计算机科学学院任助理教授;同年入选Canada CIFAR AI Chair。随后,他创立“老虎实验室(虎头帮)”,持续聚焦基础模型能力、多模态技术及评测方法论。
虎头帮的使命不止于出题,亦深耕模型与系统创新。
在视频领域,UniVideo尝试统一视频理解、生成与编辑三大任务,让模型不仅能输出画面,更能读懂内容、响应指令并完成精细修改;Vamba专注长视频理解,攻克长达一小时视频带来的显存占用、计算负载与训练效率难题;与Meta生成式AI团队合作的MoCha,则聚焦会说话的虚拟角色生成,通过语音+文本双模态输入,合成高保真人物视频。
一个从不亲自建模的出题人,很难设计出真正有穿透力的考题。自己动手造模型,反而让他们更懂如何精准评估。
因为顶级评测的本质,是对模型能力边界的深刻体察。唯有亲历模型构建全过程,了解它在真实任务中遭遇的障碍与妥协,才能设计出既拉开差距、又暴露短板的高质量题目。
如今,陈文虎已加入Meta超级智能实验室,工作重心继续锚定在多模态预训练数据构建与评估体系优化,并直接服务于Meta基础模型的研发迭代。
AI行业从不缺少聚光灯下的面孔。创业者、明星研究员、大模型公司掌舵者,天然占据舆论高地;新品发布、融资动态、开源动作与团队变动,总是最快引发关注,也让这些名字率先走入公众视野。
但今天的AI版图中,华人力量的渗透早已超越这些最耀眼的位置。
本文来自微信公众号“字母AI”,作者:小金牙,36氪经授权发布。


