





nginx反向代理实现故障隔离的核心是upstream被动健康检查,通过max_fails和fail_timeout参数控制故障判定与自动剔除,配合proxy_next_upstream重试机制及合理超时设置,确保请求绕过不可用节点。
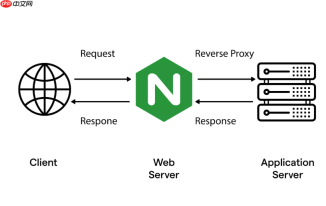
配置 Nginx 反向代理实现故障隔离,核心在于结合 upstream 健康检查 与 自动剔除机制,让请求避开不可用节点,而非简单转发。关键不是“加个 proxy_pass 就完事”,而是让 Nginx 主动识别并绕过故障后端。
定义带健康检测的 upstream 组
在 http 块中声明 upstream,并启用被动健康检查(无需额外模块):
- 使用 max_fails 和 fail_timeout 控制故障判定:比如连续 3 次失败(max_fails=3),在 30 秒内(fail_timeout=30s)不再发请求给该节点
- 可选添加 weight 区分服务器能力,backup 标记备用节点(仅当所有主节点失效时启用)
- 示例配置:
upstream app_backend {
server 10.0.1.10:8080 max_fails=3 fail_timeout=30s weight=5;
server 10.0.1.11:8080 max_fails=3 fail_timeout=30s;
server 10.0.1.12:8080 backup;
}
在 location 中正确引用并设置超时
proxy_pass 指向 upstream 名称,同时配好连接与响应超时,避免因单个后端卡住拖垮整体:

- proxy_connect_timeout 控制建立 TCP 连接的等待上限(建议 2–5 秒)
- proxy_read_timeout 控制等待后端响应数据的时间(根据业务接口合理设为 10–60 秒)
- proxy_send_timeout 控制向后端发送请求体的超时(通常与 read_timeout 一致或略短)
- 务必加上 proxy_next_upstream error timeout http_500 http_502 http_503 http_504,表示遇到这些情况就尝试下一个 upstream 节点
启用连接复用提升稳定性
减少频繁建连带来的开销和失败概率,尤其对短连接高频场景:
- 在 upstream 块中加入 keepalive 32(保持 32 个空闲长连接)
- 在 location 中添加 proxy_http_version 1.1 和 proxy_set_header Connection "",显式启用 HTTP/1.1 长连接
- 这能显著降低因连接拒绝、TIME_WAIT 爆满导致的“假性故障”
验证与观察故障隔离效果
配置生效后,不能只看是否能访问,要主动模拟故障并确认行为符合预期:
- 执行 nginx -t 测试语法,再 nginx -s reload 热加载
- 手动停掉某台后端服务,持续发起请求,观察访问是否自动切到其他节点(可用 curl 或压测工具)
- 查看 Nginx 错误日志(/var/log/nginx/error.log),搜索 “upstream failed” 或 “no live upstreams” 判断是否触发了重试或彻底失败
- 注意:Nginx 默认不记录哪台 server 被标记为 down,可通过第三方模块如 nginx-upstream-check-module 实现主动探测与状态可视化


