





要观察nginx与后端通信链路状态,需融合被动日志、主动探测和结构化状态三类信息,聚焦转发目标、响应码、耗时、缓存状态及节点健康度,并通过增强日志、vts状态页与prometheus实现可观测性闭环。
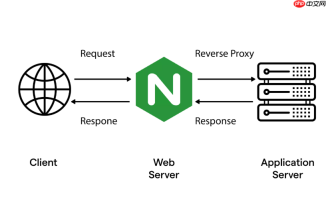
要观察 Nginx 与后端的通信链路状态,关键不是只看“通不通”,而是看清“谁在响应、响应多快、为何失败、是否被绕过”。这需要把被动日志、主动探测和结构化状态三类信息串起来,形成可定位、可告警、可回溯的链路视图。
Nginx 与后端通信链路的核心可观测维度
链路状态不能只依赖一个指标。需同时关注:
- 请求是否被转发到后端(
$upstream_addr是否为空) - 转发后是否得到响应(
$upstream_status状态码,如 200/502/504) - 响应耗时是否异常(
$upstream_response_time,单位秒,含小数) - 缓存是否介入(
$cache_status,区分 HIT / MISS / STALE / BYPASS) - 后端节点是否被临时剔除(
max_fails计数、fail_timeout剩余时间)
配置 access_log 记录真实链路行为
默认日志不包含上游信息,必须显式增强:
log_format upstream_log '$remote_addr - $remote_user [$time_local] '
                         '"$request" $status $body_bytes_sent '
                         '"$http_referer" "$http_user_agent" '
                         '$upstream_addr $upstream_response_time $upstream_status '
                         '$cache_status';
access_log /var/log/nginx/access.log upstream_log;
这样每条日志都带:
-
10.0.1.10:8080→ 实际转发目标 -
0.324→ 后端真实响应耗时(非客户端等待时间) -
502→ 后端返回错误码(非 Nginx 自身错误) -
MISS→ 本次未命中缓存,必然触发回源
暴露实时上游状态页供人工或监控调用
推荐使用 nginx-module-vts(比 stub_status 更细粒度):
vhost_traffic_status_zone;
server {
    location /status {
        vhost_traffic_status_display;
        vhost_traffic_status_display_format html;
        allow 127.0.0.1;
        allow 10.10.0.0/16;
        deny all;
    }
}
访问 /status 可看到每个 upstream server 的:
- 当前状态(up/down)
- active / max_fails / fails / rise / fall 计数
- 最近响应时间中位数与 P95
- request counter 和 response code 分布
若无法安装 vts,可用 nginx_upstream_check_module 提供的 /status(需启用 check_status 指令),输出简洁 JSON,适合脚本解析。

结合 Prometheus 实现自动化链路健康判断
通过 nginx-vts-exporter 抓取 vts 数据后,在 Prometheus 中可写如下关键查询:
- 回源失败率:
rate(nginx_upstream_response_status_count_total{upstream=~"backend.*",code=~"5.."}[5m]) / rate(nginx_upstream_response_status_count_total{upstream=~"backend.*"}[5m]) - 平均上游延迟突增:
avg_over_time(nginx_upstream_response_time_seconds_sum{upstream="app_api"}[5m]) / avg_over_time(nginx_upstream_response_time_seconds_count{upstream="app_api"}[5m]) > 1.5 - 缓存失效集中爆发:
sum(rate(nginx_cache_misses_total{zone="api_cache"}[5m])) by (instance) > 100
配合 Grafana 面板,把「上游 5xx 率」「缓存 miss 率」「单节点响应 P95」三条曲线叠加,异常点一目了然。
辅助手段:主动探测 + 被动反馈双校验
- 主动探测(需
upstream_check_module):每 3 秒发一次GET /health,仅认http_2xx,连续 3 次失败才标记 down - 被动反馈(原生支持):设
proxy_next_upstream error timeout http_502 http_503 http_504,让真实请求失败也参与计数
二者互补:主动探测保心跳,被动反馈验业务路径。缺一不可。
不复杂但容易忽略


