





upstream_response_time是nginx与后端服务完成完整交互的耗时(单位秒,毫秒精度),从发起请求到收完全部响应数据为止,仅反映后端真实处理速度,不含客户端网络、nginx解析、ssl握手及响应下发等开销;需配合proxy_pass等代理指令及命名upstream块才有效,重试时以逗号分隔多值,须结合$request_time、$upstream_addr和trace id协同分析定位瓶颈。
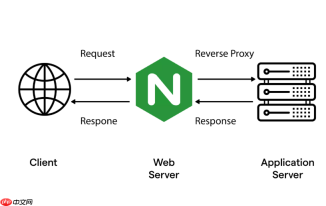
upstream_response_time 是 Nginx 访问日志中一个关键性能字段,它表示 Nginx 与后端服务(upstream)完成一次完整交互所花费的时间——具体是从 Nginx 向后端发起请求开始,到收完后端返回的全部响应数据为止的耗时(单位:秒,精度为毫秒,如 0.042)。
它只统计“后端干活那段时间”
这个值不包含:
- 客户端上传请求体的时间
- Nginx 自身解析请求头、匹配 location、执行 rewrite 等内部处理开销
- SSL/TLS 握手、DNS 解析等连接建立前置步骤
- Nginx 把响应发回客户端的网络传输时间
换句话说,它是纯粹的“后端响应耗时”,反映的是你真实业务服务(Java/PHP/Go 等)处理请求并返回结果的速度。
必须配合 upstream 配置才有效
该字段仅在使用了 proxy_pass、fastcgi_pass 等代理指令,且目标是已定义的命名 upstream 块(如 proxy_pass http://backend;)时才有数值。直接写死 IP 地址(如 proxy_pass http://127.0.0.1:8000)在部分旧版本中可能无法正确填充。
若日志中显示为 - 或为空,常见原因包括:

- 请求未走到 upstream(例如静态文件直出、4xx/5xx 错误未转发)
- 后端连接超时或主动断连(需检查
proxy_connect_timeout和proxy_read_timeout) - 配置中未启用 access_log 或 log_format 里没包含该变量
多个值用逗号分隔,代表多次调用
当发生重试(proxy_next_upstream)、子请求(auth_request)、镜像(mirror)等情况时,Nginx 可能发起多次 upstream 请求。upstream_response_time 会按顺序记录每次的耗时,例如:"0.003, 0.086, 0.001" 表示第一次失败(3ms),第二次成功(86ms),第三次又成功(1ms)。
默认情况下,日志只保留最后一次的值;但开启多段记录后,可通过日志采集工具提取首值、最大值或做 P95/P99 分位统计。
真正有用的方式是和其它字段一起看
单看一个数字意义有限,关键是组合分析:
- 对比
$request_time:若两者接近(比如都 >1s),瓶颈大概率在后端内部(DB 慢查、线程阻塞、GC);若$request_time显著更大,问题可能在客户端网络、大文件上传、Nginx 缓冲配置等 - 绑定
$upstream_addr或自定义$backend变量:把耗时和具体服务实例或服务名关联,避免只看到一串 IP 不知对应哪个系统 - 透传
X-Trace-ID并对齐后端链路日志:知道“谁慢”之后,进一步定位“为什么慢”,比如是某次 DB 查询拖慢,还是下游 Redis 超时
不复杂但容易忽略


