





nginx长连接“失控”实为上下游生命周期未对齐,需分client→nginx(keepalive_timeout/requests控制)和nginx→upstream(keepalive+http/1.1+connection空头协同)两段精准配置,缺一不可。
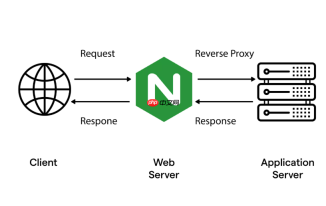
这个问题表述存在概念混淆。“全局直接执行代理时长连接脱离受控对象”并不是 Nginx 的标准行为或设计目标,也没有对应的技术术语。Nginx 本身不会让长连接“脱离受控对象”;相反,它对连接生命周期有明确、可配置的管控逻辑。真正需要厘清的是:为什么有时长连接看似“失控”(如大量 TIME_WAIT、连接复用失效、上游断连异常),其根源往往来自配置缺失、协议理解偏差或上下游协同失当。
长连接不是自动生效的,必须显式启用
Nginx 默认对客户端使用 HTTP/1.1 并继承 keep-alive,但对上游(upstream)默认用短连接。若未配置 upstream 长连接参数,每个请求都会新建 TCP 连接,造成频繁握手、TIME_WAIT 积压和性能损耗。
-
客户端到 Nginx:依赖
keepalive_timeout和keepalive_requests控制单个连接最大存活时间和请求数 -
Nginx 到上游服务:必须在
upstream块中显式声明keepalive N(连接池大小),否则不启用连接复用 - 两者独立配置,缺一不可;仅配一边,链路仍是“半长连接”,后端压力未缓解
连接复用失效的常见配置盲区
即使启用了 keepalive 32,仍可能无法复用连接,根源常在于协议头或超时不匹配:

- 上游服务响应头中含
Connection: close,会强制关闭连接,Nginx 不会缓存该连接 - 上游未正确返回
Content-Length或使用Transfer-Encoding: chunked,导致 Nginx 无法判断响应边界,不敢复用连接 -
keepalive_timeout值小于上游服务的 idle timeout(如 Tomcat 的connectionTimeout),连接被上游先断开 - 未设置
proxy_http_version 1.1和proxy_set_header Connection "",Nginx 默认以 HTTP/1.0 转发,不带 keep-alive 头
变量与日志是定位“失控”连接的关键证据
所谓“脱离受控”,往往是监控缺失导致的误判。Nginx 提供多个内置变量,可精准刻画连接状态:
-
$connection_requests:当前连接已处理请求数,对比keepalive_requests可知是否因达上限被关闭 -
$upstream_addr和$upstream_response_time:结合日志可识别某台上游是否频繁新建连接或响应延迟突增 -
$status与$upstream_status不一致(如 502/504 + upstream_status 为空),说明连接在转发前就中断,指向 upstream 连接池或网络问题 - 开启
log_subrequest on可记录子请求(如 auth_request),避免因嵌套代理掩盖真实连接行为
根本不在“脱离”,而在协同边界未对齐
Nginx 不管理上游进程,只管理与上游建立的 TCP 连接池。所谓“脱离受控”,本质是 Nginx 与上游服务在连接生命周期策略上未对齐:
- 上游若主动关闭空闲连接(如 Spring Boot 的
server.tomcat.connection-timeout),而 Nginx 还在等待复用,就会出现连接被重置 - 防火墙或云厂商 SLB 设置了 60s 空闲连接自动切断,但 Nginx
keepalive_timeout设为 120s,必然断连 - 容器环境(如 Kubernetes)中 Pod 重启或滚动更新时未优雅终止,TCP 连接被硬中断,Nginx 侧表现为
upstream prematurely closed connection


