





精准捕获转发超时报错需明确三要素:请求发起方、卡点环节、超时判定依据;须通过traceid+mdc跨异步链路透传、在超时判定处主动记录结构化日志、区分真实超时与取消干扰、构建树状链路图还原路径。
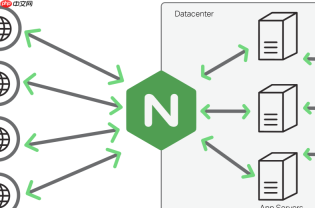
要精准捕获并还原转发超时导致的报错,关键不是“记录日志”,而是让日志能说清三件事:谁发的请求、在哪一环卡住、为什么判定为超时。异步非阻塞流(如 .NET 的 IAsyncEnumerable<t></t> 或 Python 的 async for)本身不带上下文,必须主动注入链路标识和状态标记,否则日志就是一堆时间戳堆砌的碎片。
统一 traceId + 跨阶段 MDC 透传
转发超时往往发生在网关→服务A→服务B的多跳链路中,若每跳日志无共同 traceId,就无法串起完整路径。需在入口处生成唯一 traceId,并通过 MDC(Mapped Diagnostic Context)或 contextvars 在整个异步流生命周期中透传:
- .NET 中使用
ActivitySource或DiagnosticSource自动携带 traceId,配合AsyncLocal<string></string>确保跨 await 不丢失 - Python 中用
contextvars.ContextVar存储 trace_id,在每次await前显式绑定到当前上下文 - 所有日志输出前,强制将 traceId 注入结构化字段(如
{"trace_id": "xxx"}),而非仅靠线程ID或协程ID
在超时发生点主动登记异常事件
转发超时不是“某处抛出异常”,而是“等待响应未在阈值内返回”。不能依赖 try-catch 捕获——因为超时本身常由 Task.WaitAsync、asyncio.wait_for 或下游服务无响应触发。必须在超时判定逻辑中主动写日志:
- 在
wait_for(timeout=5)的except asyncio.TimeoutError:分支里,记录原始请求参数、已耗时、下游地址、重试次数 - 在 .NET 中,
System.Collections.Async.EnumeratorMoveNext.Stop事件若延迟 >50ms 且 result 为 false,应视为潜在转发卡顿,立即打标"timeout_candidate": true - 避免只记 “Timeout occurred”,而要记 “Forward to http://svc-b:8080/api/v1/data timed out after 4982ms (threshold=5000ms), retry=2”
区分真实超时与取消干扰
用户取消、上游中断、负载均衡器主动断连,都会表现为“无响应”,但归因完全不同。日志必须明确标注超时是否由外部取消引发:
- 检查
ctx.Done()触发原因:ctx.Err() == context.DeadlineExceeded才是真超时;context.Canceled则属于主动终止 - 在
DisposeAsync或async with结束时,若发现仍有未完成的MoveNextAsync调用,说明取消未下推到底层,此时日志应标记"cancellation_leaked": true - 结构化日志中固定字段
"timeout_type": "network"/"service"/"cancel_propagation_failed",便于后续按类型聚合分析
用树状链路图还原转发路径
单条日志无法说明“为什么超时”,必须把多次转发动作组织成父子关系的执行树。例如一个请求经网关→认证服务→主业务服务→缓存代理,每跳都应生成子 span:
- 每个异步转发操作开始时,记录
{"span_id": "s2", "parent_id": "s1", "name": "forward_to_auth", "start_time": 1718552100123} - 超时发生时,该 span 标记
"status": "timeout", "duration_ms": 4990,并关联其 parent_id 形成可展开的树 - 借助 PerfView(.NET)或 OpenTelemetry(Python/Go)导出 trace 数据,自动渲染为时序图,一眼看出是第几跳耗时突增


