





worker进程的健康检查不提供物理隔离,仅作为触发隔离策略的信号源;真正物理隔离需结合网关架构、资源调度及基础设施层控制(如节点亲和性、网络平面分离、资源配额限制)共同实现。
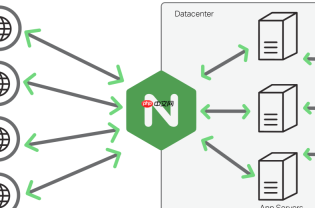
Worker进程的自主健康检查机制本身不直接提供物理隔离能力,但可以作为触发隔离策略的关键信号源。真正的物理隔离需结合网关架构设计与资源调度策略来实现,而非仅靠健康检查逻辑本身。
理解Worker健康检查的作用边界
Worker进程(如Nginx或APISIX中)的健康检查通常指其对上游服务节点的探测行为(主动/被动),而非自身状态的自检。所谓“自主健康检查”,实质是Worker周期性发起探活请求并依据响应结果更新节点权重或剔除异常节点——它影响的是流量路由决策,不是进程本身的启停或资源划分。
因此,不能依赖Worker健康检查直接实现物理隔离;但它可作为判断上游服务是否可信的依据,进而驱动下游隔离动作。

通过健康检查结果触发流量级物理隔离
当健康检查发现某类上游服务持续异常时,可联动网关策略,将对应请求导向独立资源池:
- 按服务分组绑定专属Worker子集:在APISIX或Nginx中配置不同upstream指向不同worker监听端口(如9080处理订单服务、9081处理用户服务),每个端口由独立worker进程组承接,避免单点过载扩散
- 基于健康状态动态切换后端集群:若订单服务A集群连续5次健康检查失败,网关自动将所有订单请求路由至备用集群B,并关闭A集群对应的worker连接池,实现业务维度的物理路径隔离
- 熔断+线程池隔离双生效:健康检查标记节点异常后,触发Hystrix式熔断;同时网关为该服务分配专用线程池(如Java网关)或Lua协程调度队列(如APISIX),确保失败请求不挤占其他服务的执行资源
配合进程级与网络层隔离增强实效
单靠Worker内调度无法达成真正物理隔离,需叠加基础设施层控制:
- 容器编排约束:在Kubernetes中为不同业务域的网关Pod设置nodeSelector或topologySpreadConstraints,使其运行在不同物理节点或可用区,天然隔离硬件故障域
- 网络平面分离:为高优先级服务(如支付)配置独立VPC或子网,网关实例通过不同ENI接入,避免共享网络带宽和ARP表项干扰
- 资源配额硬限制:在宿主机或容器运行时(如containerd)为各网关实例设置CPU CFS quota与memory limit,防止某一Worker因上游异常导致资源耗尽而拖垮同节点其他进程
避免常见误用陷阱
实践中需注意以下关键点:
- 健康检查间隔不宜过短(建议≥5秒),否则高频探测可能反向压垮上游,造成“检查引发故障”
- 被动检查必须与主动检查共存——仅靠被动模式无法感知已恢复节点,会导致隔离状态长期滞留
- K8s服务应使用Pod Liveness Probe而非网关层健康检查,因后者仅适用于IP直连型后端,对Service ClusterIP无效
- HTTP状态码配置需谨慎:将429(限流)设为健康码可能导致网关误判服务可用,应根据实际语义区分“正常拒绝”与“异常不可用”


