





nginx健康检查需主动与被动结合:主动检查用health_check配置探测间隔、失败/恢复阈值及轻量路径;被动检查靠max_fails和fail_timeout兜底;配合proxy_next_upstream重试与监控告警实现高可用。
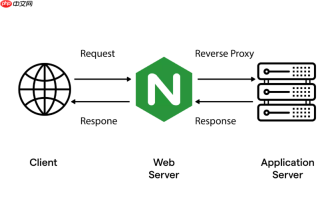
通过 Nginx 的 upstream 健康检查机制,可以显著提升后端服务的可用性和请求分发稳定性。关键不在于简单启用健康检查,而在于合理配置探测方式、失败判定逻辑和恢复策略,避免误判或雪崩。
启用并配置主动健康检查(health_check)
Nginx Plus 原生支持主动健康检查(开源版需搭配 nginx-plus-module-healthcheck 或使用第三方模块如 ngx_http_upstream_check_module)。它会定期向每个 upstream server 发送探测请求,根据响应状态自动标记/摘除节点。
- 使用
health_check指令时,建议指定interval=3s、fails=2、passes=2,避免过频探测增加后端压力,也防止单次抖动导致误摘除 - 探测路径应为轻量接口(如
/healthz),返回200 OK且响应体为空或极小,避免引入额外延迟 - 可配合
match块校验响应头或 body 内容,例如确认Content-Type: application/json或包含"status":"ok"
结合被动健康检查(max_fails + fail_timeout)兜底
即使未启用主动检查,Nginx 开源版也支持基于实际请求失败的被动探测。这是保障稳定性的基础防线。

-
max_fails=3表示连续 3 次请求失败(超时、5xx、连接拒绝等)即标记为不可用 -
fail_timeout=30s指该节点被标记后,在 30 秒内不再转发新请求;到期后自动重试一次,成功则恢复,失败则重置计时 - 注意:
max_fails=0表示禁用被动检查;设为1容易因偶发超时误剔除,不推荐
设置合理的重试与容错策略
健康检查只是“发现”问题,真正的稳定性还依赖请求层的容错行为。
- 在
location块中使用proxy_next_upstream error timeout http_500 http_502 http_503 http_504,允许在上游异常时自动转发给下一个可用节点 - 搭配
proxy_next_upstream_tries 3限制最多尝试次数,防止长尾请求无限重试 - 慎用
http_404或http_403加入重试列表——这类响应通常是业务逻辑结果,不应重试
监控与可观测性落地要点
健康检查的价值取决于能否及时感知和干预。仅靠配置不够,需打通可观测链路。
- 启用
stub_status或 Nginx Plus 的statusAPI,暴露每个 upstream server 的state(up/down/unhealthy)、fails、health_checks等指标 - 将这些指标接入 Prometheus(如通过
nginx-prometheus-exporter),设置告警规则:如 “连续 2 分钟某节点处于 down 状态” - 记录
upstream_addr和upstream_status到 access log,便于回溯具体哪次请求被转发到哪个后端及结果


