





nginx反向代理与后端协程服务协同时因连接生命周期管理错位导致内存泄漏,需从协程上下文释放、nginx配置调优、异步兜底回收三方面解决:绑定session id并设双重清理机制;禁用proxy_buffering、延长proxy_read_timeout、启用http/1.1复用;定时扫描清理超时session并监控告警。
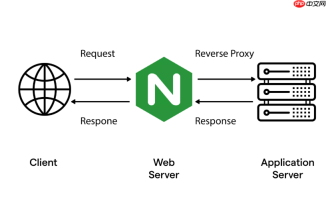
这个问题本质是 Nginx 作为反向代理层,与后端协程服务(如 Swoole/Go/Node.js 流式服务)协同时,因连接生命周期管理错位,导致后端协程上下文无法及时释放,进而引发内存持续增长。它不是单纯“Nginx 销毁代理”造成的,而是 Nginx 的连接关闭行为与后端协程的资源清理逻辑未对齐所致。
下面从三个关键层面给出可落地的解决路径:
明确协程上下文的持有边界与释放时机
后端服务(例如基于 Swoole 协程的文档协作服务)中,每个实时编辑会话通常对应一个协程+内存上下文(如操作历史 buffer、用户状态、锁资源)。这个上下文必须在客户端断连且服务端确认无残留流量后才释放。常见错误是:
- 仅靠
onClose回调释放,但 Nginx 可能提前关闭 TCP 连接(如超时、buffering 截断),导致回调未触发; - 依赖协程自动退出,但流式长连接下协程可能挂起等待数据,不主动结束;
- 未设置协程级超时或心跳保活,使“僵尸协程”长期驻留。
✅ 建议做法:
- 后端为每个协程绑定唯一 session ID,并注册到全局协程管理器(如
Swoole\Table或 Redis Hash); - 设置双重清理机制:
- 主动心跳检测(客户端每 15s 发
ping,服务端 30s 未收到则co::cancel()协程并清 context); - 被动连接关闭监听(
$server->on('close', fn($serv, $fd) => clearContext($fd))),并配合setConnectionTimeout(45)防止假死;
- 主动心跳检测(客户端每 15s 发
- 所有上下文对象(如 undo stack、presence map)使用弱引用或手动
unset(),避免闭包持有所致的循环引用。
配置 Nginx 以匹配协程服务的真实生命周期
Nginx 默认行为(如 proxy_buffering on、proxy_read_timeout 60)会掩盖真实连接状态,让后端误判客户端仍在线。

✅ 关键配置项(放在具体 location 块内,如 /api/doc/stream):
-
proxy_buffering off;—— 禁用缓冲,确保 chunked 数据逐包透传,不累积; -
proxy_read_timeout 90;—— 设为略大于后端协程心跳超时(如后端设 60s 心跳,则 Nginx 至少 90s),避免 Nginx 先断; -
proxy_http_version 1.1;+proxy_set_header Connection '';—— 强制复用 HTTP/1.1 连接,禁用 Connection: close 干扰; -
chunked_transfer_encoding on;—— 显式启用分块编码,适配 SSE/自定义流协议; -
proxy_pass_request_headers on;+underscores_in_headers on;—— 确保X-Session-ID、X-User-Token等上下文标识头完整透传,不被过滤。
在代理链路中注入上下文追踪与兜底回收
即使前两步到位,网络抖动、客户端异常退出(如 kill tab)仍可能导致上下文残留。需引入异步兜底机制。
✅ 实施方案:
- 后端服务启动定时协程(如每 60s),扫描
Swoole\Table中 last_active_time 超过 120s 的 session,强制清理; - 将 session 生命周期事件(create/close/clear)写入 Kafka 或 Redis Stream,供独立监控服务消费,生成泄漏告警;
- 对高危上下文(如含大 buffer 的 diff state),添加内存占用阈值(如 >2MB),超限立即
co::cancel()并记录堆栈; - 在
onWorkerStart中注册pcntl_signal(SIGUSR1, fn() => dumpAllContexts()),支持运维手动触发上下文快照排查。
不复杂但容易忽略——真正的上下文泄漏,往往藏在“以为已断开”的间隙里。把连接状态、心跳信号、超时策略三者对齐,再加一层异步兜底,就能把泄漏率压到接近零。


