





实现后端服务下线不丢请求,关键是nginx提前摘流并配合后端draining:通过/health/ready探针、主动健康检查或weight=0热重载实现流量规避,延长超时、保持连接、忽略客户端中断,并由后端控制退出节奏,最终实测验证闭环。
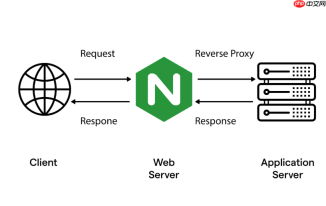
让后端服务下线不丢请求,关键不是等 Nginx “反应过来”,而是让它提前避开、留足时间、配合收尾。Nginx 本身不主动监听 shutdown 信号,但能通过配置+后端协作,实现零报错摘流。
主动探测 + 探针切换,提前摘除流量
别等请求打过去失败才换节点。必须让 Nginx 在后端真正停机前就停止派发新请求:
- 后端暴露 /health/ready 接口,正常返回 200,准备下线时主动返回 503 或切换为
{"status":"DOWN"} - upstream 中启用主动健康检查(需编译 check 模块):
check interval=3 rise=2 fall=3 timeout=1 type=http;check_http_send "GET /health/ready HTTP/1.1\r\nHost: example.com\r\n\r\n";check_http_expect_alive http_2xx http_5xx;(含 503 才能识别主动下线) - 或更轻量方式:下线前手动把对应 server 的 weight=0,再执行
nginx -s reload热更新 upstream,无需重启
延长超时 + 保持连接,保障存量请求走完
已建立的连接不能被突然中断,Nginx 需配合后端 draining 时间窗:

- 设置 proxy_read_timeout 为业务最长处理时间(如 60s),确保后端有足够时间完成已接收请求
- 启用 HTTP/1.1 和 keep-alive:
proxy_http_version 1.1;proxy_set_header Connection "keep-alive"; - upstream 块中加 keepalive 32,复用连接,减轻后端重建压力
- 开启 proxy_ignore_client_abort on,防止用户关闭页面导致 Nginx 提前终止后端仍在处理的请求
后端必须承担退出节奏
Nginx 是协调者,不是执行者。真正决定是否“安全”的是后端行为:
- 收到 SIGTERM 后,立即关闭新请求入口——停用 Tomcat connector、暂停 Netty EventLoop、或拒绝新 TCP 连接
- 同时保持已有连接可读写,不主动 close,等待活跃连接自然归零
- 通过 stub_status(如
location /status { stub_status; })监控Active connections,确认归零后再终止进程 - 若用 systemd,配置
ExecStop=/usr/bin/nginx -s quit和足够长的TimeoutStopSec=45,避免强制 kill
验证闭环,别只看配置
上线前必须实测整个链路是否真正无感:
- 运行
nginx -T,确认 check 指令已生效、weight 已置 0 - 访问
/status,观察目标节点状态变为down,且 Active connections 缓慢下降至 0 - 模拟下线:curl 后端 /health/ready → 查 Nginx access.log 是否不再向该节点转发 → 确认响应无 502/503 报错
- 建议接入 nginx-module-vts + Prometheus,对连接数、状态码、上游节点状态做自动化监控与告警


