





构建nginx缓存监控与告警系统需三步:采集真实指标(stub_status、$upstream_cache_status等)、建立健康基线、触发可操作告警;通过轻量工具链(filebeat/vector、shell脚本、blackbox_exporter)实现,告警须带上下文与诊断线索。
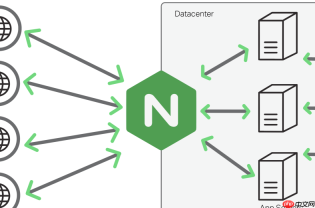
构建 Nginx 缓存监控与告警的自动化管理系统,核心在于三件事:采集真实缓存指标、建立可追踪的健康基线、触发精准且可操作的告警。不依赖商业方案也能落地,关键是把 Nginx 的原生能力(如 stub_status、$upstream_cache_status)和轻量工具链串起来。
从 Nginx 暴露可信缓存指标
Nginx 本身不直接输出缓存命中率等聚合数据,需组合配置获取基础信号:
- 启用 ngx_http_stub_status_module,暴露连接数、请求总数等运行态数据(需编译时包含或确认已加载);
- 在日志格式中嵌入 $upstream_cache_status 变量,例如:log_format cache '[$time_local] $remote_addr "$request" $status $body_bytes_sent "$http_referer" "$http_user_agent" "$upstream_cache_status"';
- 为缓存后端(如 proxy_cache_path)配置 cache manager 进程监控项,通过 /var/cache/nginx/ 目录的磁盘使用、inode 占用、活跃缓存条目数间接反映缓存健康度;
- 若使用 OpenResty,可用 lua_shared_dict 在内存中实时统计命中/未命中次数,再通过 Lua API 暴露为 HTTP 接口供采集。
用轻量工具链完成指标采集与聚合
避免重装 Prometheus 全家桶,优先复用已有基础设施:

- 用 filebeat + logstash 或 vector 实时解析 access 日志,按 $upstream_cache_status 字段(HIT/MISS/EXPIRED/STALE/BYPASS 等)做计数聚合,每分钟输出一个指标快照;
- 写一个简单 shell 脚本定期调用 curl http://127.0.0.1/nginx_status 和 du -sh /var/cache/nginx,将结果转成 Prometheus 格式文本文件,由 node_exporter textfile collector 自动读取;
- 对关键缓存 location,加一段 return 200 "cache_ok" 的健康检查 endpoint,并用 blackbox_exporter 检测响应头中的 X-Cache: HIT,实现缓存服务级探活。
定义可执行的告警规则而非阈值堆砌
缓存告警容易误报,重点不是“命中率低于 85%”,而是识别异常模式:
- 命中率突降 >30% 且持续 5 分钟 → 检查上游源站是否异常返回 5xx 或 302,导致缓存失效;
- MISS + BYPASS 请求占比超 60%,但源站响应时间正常 → 可能是 proxy_cache_bypass 或 proxy_no_cache 规则被意外触发;
- 缓存目录磁盘使用率 >90% 且 cache manager 进程 CPU 占用持续高于 80% → 缓存清理滞后,存在雪崩风险;
- 连续 3 次 blackbox 探针未收到 X-Cache: HIT → 缓存模块可能已停用或配置丢失。
告警必须带上下文,才能快速定位
每次告警推送不能只说“缓存异常”,要附带即时可查线索:
- 在 Alertmanager 的 annotations 中动态填入:当前命中率、最近 10 分钟 MISS 请求 Top 3 URI、对应 upstream 名称、缓存路径磁盘剩余空间;
- 告警消息里放一个临时链接,指向 Grafana 面板并自动带时间范围与过滤标签(如 ?from=now-15m&to=now&var-upstream=api_backend);
- 对高频 MISS 类告警,自动执行一条诊断命令(如 nginx -T | grep -A5 'location ~* \.js' | grep cache),结果以附件形式发到运维群。


