





nginx原生不支持严格熔断,但可通过limit_req限流、max_fails/fail_timeout被动健康检查、openresty+lua实现滑动窗口失败率统计与半开状态等轻量级熔断降级方案。
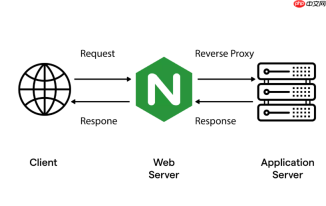
直接用 Nginx 做熔断和限流,其实有天然限制:Nginx 本身不维护服务健康状态,也不支持动态阈值或失败计数器,所以严格意义上的“熔断”(如 Hystrix 那种开/关状态切换)无法原生实现。但通过组合 ngx_http_limit_req_module、ngx_http_upstream_module 的健康检查机制,以及第三方模块(如 nginx-upstream-check-module 或 OpenResty 的 Lua 脚本),可以构建出接近生产可用的轻量级熔断+限流方案。
限流:用 limit_req 控制请求速率
这是 Nginx 最成熟、开箱即用的能力。核心是定义一个共享内存区域来统计请求频次,并绑定到 location 或 server 块。
- 在
http块中定义限流规则:
limit_req_zone $binary_remote_addr zone=ip_limit:10m rate=5r/s; - 在 upstream 或 location 中启用:
limit_req zone=ip_limit burst=10 nodelay; —— 允许突发 10 个请求,超出立即拒绝(HTTP 503) - 若需按接口路径限流,可改用
$uri或$request_uri作为 key;按用户 ID 限流则需配合后端透传 header(如X-User-ID)
被动健康检查:靠 fail_timeout + max_fails 实现基础“熔断”
Nginx 自带的 upstream 健康探测是被动的:它不主动发探针,而是根据真实请求的失败情况(超时、5xx、连接拒绝等)做统计,触发临时摘除节点。

- 配置示例:
upstream backend {
server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
} - 含义:单个节点连续 3 次失败(默认含 5xx、超时、connect refused),就会被标记为不可用,持续 30 秒不转发请求
- 注意:该机制不感知服务是否“已恢复”,只是时间到期后自动重试一次;且失败判定依赖 proxy_next_upstream 设置(需显式开启)
主动健康检查:用第三方模块补足短板
官方 Nginx 不支持主动心跳探测,生产环境建议引入 nginx-upstream-check-module(需重新编译)或使用 OpenResty(自带 lua-resty-healthcheck)。
- 以 check 模块为例,可在 upstream 中添加:
check interval=3 rise=2 fall=5 timeout=1 default_down=false;
check_http_send "HEAD /health HTTP/1.0\r\n\r\n";
check_http_expect_alive http_2xx http_3xx; - 每 3 秒对每个节点发一次 HEAD 请求;连续 2 次成功标记为 up,连续 5 次失败标记为 down
- 搭配
check_shm_size和自定义 error_page,还能把健康状态暴露给监控系统
进阶:用 Lua 实现带状态的熔断逻辑
如果需要真正的熔断器(如滑动窗口失败率统计、半开状态、回调通知),OpenResty 是更现实的选择。
- 利用
resty.limit.count或resty.healthcheck模块,结合 shared_dict 存储失败计数与时间戳 - 在 access_by_lua_block 中判断当前失败率是否超过阈值(如 50%),若是则跳过 upstream,直接返回 503 并记录日志
- 半开状态可通过定时器或首次成功请求触发状态迁移,逻辑比纯配置灵活得多
不复杂但容易忽略:限流和熔断效果必须配合合理的客户端重试策略与降级预案,否则单纯拦住请求反而放大雪崩风险。


