





正则不是不能用,真正容易出问题的是返回值判断、编码和复杂规则失控。
一、返回值定位:preg_match() 的 0 和 false 不是一回事
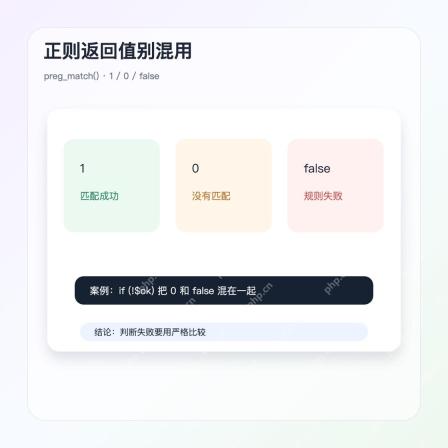
preg_match() 匹配成功返回 1,没有匹配返回 0,执行失败返回 false。这三个结果看起来都很小,但业务含义完全不同。
很多线上问题来自这种写法:
if (!preg_match($pattern, $value)) {
    return false;
}
这行代码会把“没有匹配”和“正则规则写错”混在一起。表单校验里可能还能忍,风控规则、黑名单过滤、内容审核这类场景就很危险。
建议拆开判断:
· 1 表示命中规则。
· 0 表示没命中规则。
· false 表示规则执行失败,要记录日志。
$ok = preg_match($pattern, $value);

if ($ok === false) {
    error_log('regex failed: ' . $pattern);
}

if ($ok === 1) {
    // 命中规则
}
遇到动态拼出来的规则,更要这样写。规则一旦拼坏,直接当成“不匹配”放过去,后面会很难查。
二、中文匹配:表单昵称校验别漏 u 修饰符
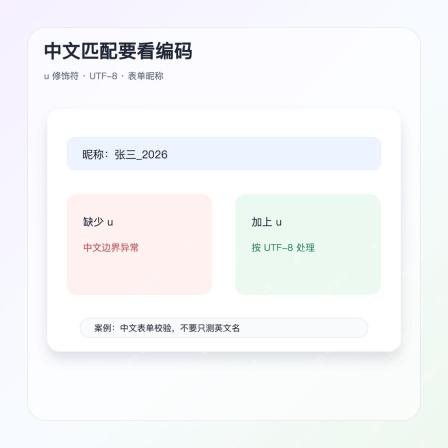
中文昵称、标题、地址校验里,正则经常写得没错,但就是匹配不稳定。这个时候先看编码和 u 修饰符。
比如校验中文、英文、数字和下划线:
$pattern = '/^[\p{Han}A-Za-z0-9_]{2,20}$/u';

if (preg_match($pattern, $nickname) !== 1) {
    return false;
}
u 会让模式按 UTF-8 处理。没有它时,多字节字符边界容易变得难理解,尤其是用了 \p{Han} 这类 Unicode 字符属性时。
排查中文正则时,建议准备几组真实数据:
· 纯中文,比如 张三。

· 中文加数字,比如 张三2026。
· 中文加符号,比如 张三_01。
· 表情或非常规字符,确认是否要拒绝。
别只拿英文用户名测。英文能过,不代表中文规则就稳。
三、性能取舍:纯包含判断别硬上 preg_match()
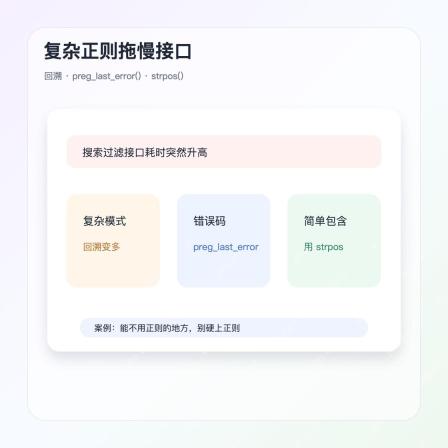
正则很方便,但不是所有字符串判断都适合它。只是判断一段文本里有没有某个固定关键词,用 strpos() 会更直接,也更容易读。
if (strpos($content, '退款') !== false) {
    // 命中关键词
}
复杂正则还可能遇到回溯过多的问题。接口耗时突然升高,排查时可以把规则、输入长度、耗时打到日志里,再结合 preg_last_error() 看是否出现正则层面的错误。
我一般按这个思路拆:
· 固定关键词:优先用 strpos()。
· 简单格式校验:使用短正则,并配测试样例。
· 复杂内容解析:考虑拆成多步,不把所有逻辑塞进一个模式。
· 用户可控输入很长时,限制长度再匹配。
正则写得越短越好维护。真正要留意的是失败分支:没匹配、规则错误、性能异常,要能在日志里分得出来。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





