





PHP 中文字符串别直接用 strlen() 和 substr()
中文标题、昵称、摘要这些字段,长度校验和截断都要按字符处理,按字节处理就容易误判或切出乱码。
输入中文文本
→ 统一 UTF-8
→ mb_strlen() 校验字符数
→ mb_substr() 安全截断
→ 展示和入库分开判断
这个坑在后台表单里特别常见。产品要求标题 20 个字以内,开发写了 strlen(),中文用户刚输入几个字就提示超长;列表摘要用 substr() 截断,页面末尾冒出乱码符号。问题不在业务规则,而在你用字节函数处理了多字节字符。
现象对照:strlen() 算的是字节,不是中文字数
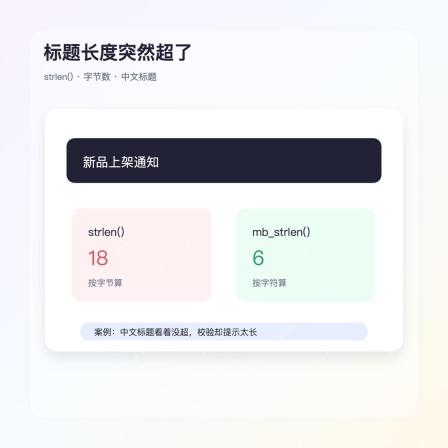
在 UTF-8 里,一个中文通常占多个字节。strlen() 返回的是字符串字节数,所以同一个中文标题,用它算出来会比肉眼看到的字数大很多。做标题长度、昵称长度、摘要长度时,这个结果很容易误导。
strlen('新品上架通知');
mb_strlen('新品上架通知', 'UTF-8');
• 数据库存储容量看字节,用户输入限制看字符。
• 表单提示“最多 20 字”,就应该用 mb_strlen()。
• 英文、数字、中文混在一起时,更要统一判断口径。
用户关心的是字数,PHP 默认字符串函数关心的是字节。
排查这类问题时,先拿一段固定中文在本地打印 strlen() 和 mb_strlen(),差异会很直观。
截断规则:列表摘要用 mb_substr() 更稳
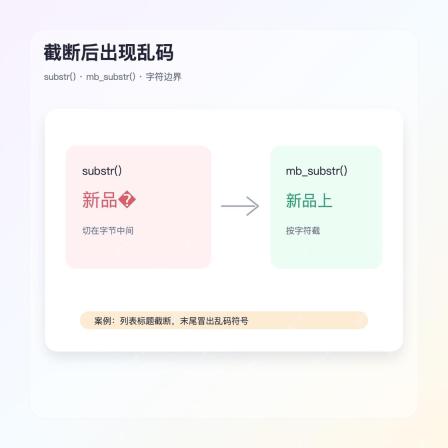
substr() 按字节截取。如果刚好切在一个中文字符的中间,页面就可能出现乱码或替换符。列表标题、通知摘要、搜索结果高亮,这些地方都建议用 mb_substr()。
$summary = mb_substr($title, 0, 12, 'UTF-8');
• 截断长度用字符数表达,和页面展示规则保持一致。
• 需要省略号时,先截字符,再拼接展示符号。
• 不要先 substr() 再修乱码,源头就该按字符切。
切中文时,边界比长度更重要。
如果内容里有表情符号,处理会更复杂,普通 mb_substr() 也未必完全符合用户感知字符。标题和摘要场景里,先把中文截断这层处理对,已经能避开大部分问题。
编码选择:不要让 mb_internal_encoding() 变成隐形依赖
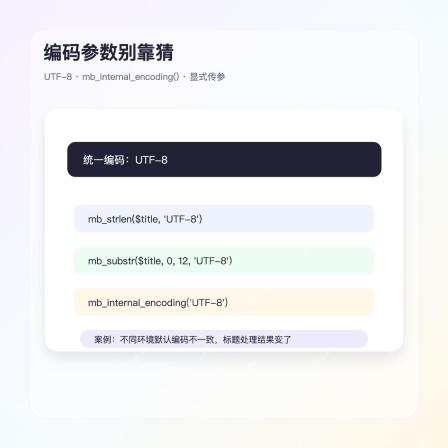

mb_strlen()、mb_substr() 都可以传编码参数。项目里最好显式写 UTF-8,不要完全依赖环境默认值。不同机器、不同 PHP 配置下,默认编码不一致时,结果可能变得很怪。
mb_strlen($title, 'UTF-8');
mb_substr($title, 0, 20, 'UTF-8');
• 入口、数据库、页面输出尽量统一到 UTF-8。
• 公共字符串工具函数里,编码参数不要省。
• 老项目如果混过编码,先确认数据源,再谈截断。
编码靠猜,迟早会在某台机器上翻车。
如果团队已经封装了字符串助手,建议把编码固定在函数内部,调用方只关心业务长度。
上线检查:长度、截断、存储容量要分开看
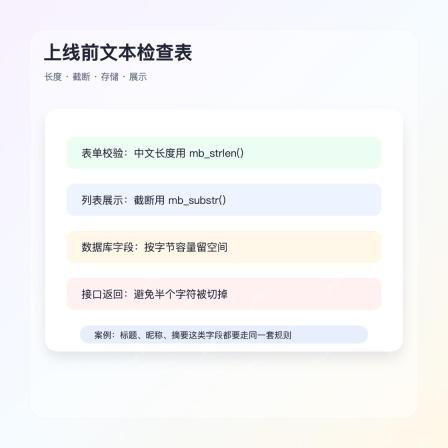
中文字符串处理不能只看一个函数。表单校验看字符数,列表展示看安全截断,数据库字段看字节容量,接口返回还要避免半个字符被切掉。
• 标题、昵称、摘要这类字段,用 mb_strlen() 做输入限制。
• 展示截断统一走 mb_substr(),不要散落在模板里。
• 数据库字段长度按真实存储估算,别只按字数拍。
• 接口返回前不要用字节截断中文内容。
校验、展示、存储是三件事,不要用一个判断全包。
这类问题通常不难修,麻烦在散。把字符串处理收进一个工具函数,再把规则写清楚,后面新增字段就不容易重复踩坑。
php免费学习视频:立即使用
踏上前端学习之旅,开启通往精通之路!从前端基础到项目实战,循序渐进,一步一个脚印,迈向巅峰!





