





nginx 不记录后端错误堆栈,仅转发响应;堆栈需由后端应用自身记录,nginx 可通过增强日志格式、透传请求 id 和上游状态等辅助定位问题。
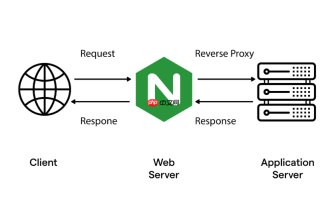
Nginx 本身不记录后端服务返回的错误堆栈——它只转发响应,不会解析或捕获后端应用(如 Java、Node.js、Python)抛出的异常详情。所谓“详细错误堆栈”,实际存在于后端日志中,Nginx 只能帮你把请求上下文留得更全、让问题可追溯,并配合后端暴露关键信息。
以下是真正可行且实用的做法:
明确 Nginx 的角色边界
- ✅ Nginx 能记录:客户端 IP、请求路径、HTTP 方法、状态码、上游地址、响应时间、超时原因、连接拒绝等代理层错误
- ❌ Nginx 不能记录:Java 的
Exception.printStackTrace()、Node.js 的err.stack、Python 的 traceback ——这些必须由后端应用自身记录并输出到其日志文件中
让 Nginx 日志包含更多诊断线索
在 http 或 server 块中增强 log_format,加入反向代理相关变量:
log_format proxy_detail
  '$remote_addr - $remote_user [$time_local] '
  '"$request" $status $body_bytes_sent '
  '"$http_referer" "$http_user_agent" '
  'upstream:$upstream_addr '
  'upstream_status:$upstream_status '
  'request_time:$request_time '
  'upstream_response_time:$upstream_response_time '
  'upstream_connect_time:$upstream_connect_time';

access_log /var/log/nginx/access.log proxy_detail;
error_log /var/log/nginx/error.log warn;
关键字段说明:
-
$upstream_addr:实际转发到的后端地址(如127.0.0.1:8080) -
$upstream_status:后端返回的真实 HTTP 状态码(如500、400) -
$upstream_response_time:后端处理耗时,若为-或超长,提示后端卡死或超时 -
upstream_connect_time为-通常意味着后端未监听或网络不通
把后端错误体内容透传给前端(仅限调试阶段)
默认情况下,Nginx 对 5xx 错误会截断响应体(尤其当 proxy_intercept_errors on 启用时)。若需临时查看后端堆栈:

- 关闭错误拦截:注释或删掉
proxy_intercept_errors on; - 确保后端已将堆栈写入响应体(如 Spring Boot 开启
server.error.include-stacktrace=always) - 配置
proxy_buffering off;(避免缓冲截断大响应)
⚠️ 注意:生产环境严禁开启,会泄露敏感信息和系统结构
真正定位堆栈的推荐做法
后端服务必须启用结构化错误日志(如 Logback + JSON 格式),记录完整 traceId、堆栈、请求参数
-
在 Nginx 中注入唯一请求 ID,与后端日志打通:
proxy_set_header X-Request-ID $request_id;
proxy_set_header X-Forwarded-For $remote_addr;
后端框架读取
X-Request-ID并写入每条日志,便于全链路检索 -
查错流程应是:
- 从 Nginx access log 找到异常请求(如
500+upstream_addr=127.0.0.1:8080) - 提取该请求的
$request_id或$remote_addr+$time_local - 去对应后端服务的日志中搜索该 ID 或时间范围,直接定位堆栈
- 从 Nginx access log 找到异常请求(如
不复杂但容易忽略


