





优化nginx大规模请求队列需控流入、稳连接、减堆积、防雪崩:设listen backlog、调大somaxconn与tcp_max_syn_backlog;用limit_req_zone限流+burst排队;upstream启用keepalive并同步超时;收紧header缓冲、大body落盘、关闭非关键日志。
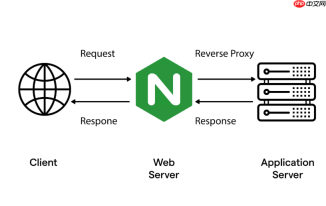
优化 Nginx 处理大规模请求队列,核心是“控流入、稳连接、减堆积、防雪崩”,不是单纯拉高并发数,而是让流量在可控缓冲、合理排队和快速释放之间取得平衡。
精准控制入口连接与队列深度
避免连接在内核态堆积或被直接拒绝,需从监听层就设定缓冲边界:
- 在 listen 指令中显式设置 backlog,例如
listen 80 backlog=4096;,提升 TCP 连接等待队列长度,防止突发流量下 accept 队列溢出丢包 - 配合系统级参数调整:
net.core.somaxconn(建议 ≥ 4096)和net.ipv4.tcp_max_syn_backlog(同步调大),确保内核能承接住 Nginx 的 backlog 请求 - 不依赖默认值——Linux 默认
somaxconn往往只有 128,远低于高并发场景实际需求
分层限流 + 动态排队机制
对超出瞬时处理能力的请求,不直接 503,而是引入可配置的排队缓冲:

- 使用 limit_req_zone 定义基于客户端 IP 或请求路径的速率限制区域,例如:
limit_req_zone $binary_remote_addr zone=perip:10m rate=10r/s; - 在 location 中启用排队:
limit_req zone=perip burst=50 nodelay;(允许最多 50 个请求暂存排队,nodelay表示不延迟响应,但超限即拒) - 若需更柔性的等待行为,去掉
nodelay,Nginx 会按速率平滑释放排队请求,避免脉冲式冲击后端
上游连接池与长连接协同管理
请求队列压力常源于后端响应慢导致连接积压,必须收紧 upstream 连接生命周期:
- upstream 块中启用 keepalive 连接复用:
keepalive 200;(推荐 100–300),并配keepalive_requests 1000;控制单连接最大请求数 - 强制 HTTP/1.1 + 清除 Connection 头:
proxy_http_version 1.1;<br>proxy_set_header Connection "";
- proxy_read_timeout 须略小于后端 keepalive timeout(如后端设 60s,则 Nginx 设 55s),避免因超时不同步造成连接泄漏
轻量缓冲 + 内存敏感型配置
每个排队/待处理请求都会占用缓冲内存,需收缩非必要分配:
- 收紧 header 缓冲:
client_header_buffer_size 1k;和large_client_header_buffers 2 2k;,防恶意 header 耗尽内存 - 上传类请求启用磁盘落盘:
client_body_in_file_only clean;,避免大 body 占用 worker 内存 - 关闭非关键日志:
access_log off;或仅记录错误级,减少 I/O 和内存写入压力


