





关键在于将nginx日志视为系统脉搏,通过规范日志格式(含$status、$upstream_status等字段)、定时脚本分析核心指标(5xx率、后端慢响应等)、对接日志中心实现可视化告警,并结合ai归因分析实现预防性运维。
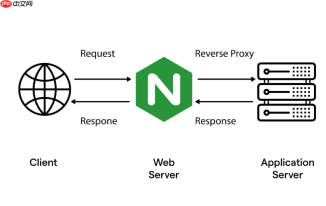
要生成基于 Nginx 日志的自动化健康巡检报告,关键不是单纯统计访问量,而是把日志当作系统“脉搏”来读——从中识别异常模式、服务瓶颈和潜在故障。这需要日志采集规范、分析逻辑清晰、输出结果可读可用。
确保日志格式统一且含关键字段
默认的 combined 日志缺少运维诊断所需细节。建议在 nginx.conf 中自定义 log_format,至少包含以下字段:
- $status:HTTP 状态码(区分 2xx/4xx/5xx)
- $upstream_status:上游响应状态(判断后端是否异常)
- $upstream_response_time:后端处理耗时(定位慢接口)
- $request_time:Nginx 总响应时间(含网络+后端)
- $http_user_agent 和 $remote_addr:辅助识别爬虫或攻击源
示例配置:
log_format health_log '$remote_addr - $remote_user [$time_local] "$request" $status $body_bytes_sent "$http_referer" "$http_user_agent" $request_time $upstream_response_time $upstream_status';用脚本定时提取核心健康指标
每天凌晨运行一个轻量 Bash 脚本(如 nginx_health_report.sh),对昨日日志做聚合分析:
- 统计各状态码占比,突出 5xx 错误率是否超阈值(如 >0.5%)
- 筛选 upstream_status 为 “500”、“502”、“503” 或为空 的请求,汇总对应 upstream 名称和错误次数
- 找出 request_time > 3s 且 upstream_response_time > 2.5s 的请求,标记为“后端慢响应”
- 统计每分钟请求数(QPS)曲线,识别突增/骤降时段并关联错误率变化
工具链推荐:awk + sort + uniq -c 做基础聚合,配合 grep -E ' 50[0-3] | - ' 快速抓取异常行。

对接日志中心实现可视化与告警
单靠脚本输出文本报告易被忽略。更可靠的做法是将结构化指标写入日志服务(如阿里云 SLS、ELK):
- 将每日分析结果以 JSON 格式发送到专用 LogStore,字段包括:date、5xx_rate、backend_502_count、slow_req_count、peak_qps
- 在日志中心创建仪表盘,用折线图展示 5xx 趋势、柱状图对比各 upstream 错误分布
- 配置智能告警规则:例如“连续 2 次检查中 5xx_rate > 1% 且 backend_502_count > 50”,触发钉钉/邮件通知
这样,报告不再是静态快照,而成为可下钻、可回溯、可联动处置的活数据流。
结合 AI 做归因分析(进阶)
当发现某天 502 骤增,传统脚本只能告诉你“发生了”,AI 可帮你回答“为什么”:
- 将当日异常日志片段、系统监控数据(CPU/内存)、部署变更记录一起喂给 Nanbeige4.1-3B 类模型
- 提示词示例:“请分析以下 Nginx 异常日志和上下文,指出最可能的根本原因,并按可能性排序:1)后端进程 OOM 被杀;2)数据库连接池耗尽;3)新版本代码引入空指针”
- 模型可结合语义理解与历史模式,输出类似“87% 概率是 Java 应用因内存泄漏触发 full GC,导致 upstream_timeout,建议检查堆 dump”的判断
这一步让巡检从“可观测”迈向“可推理”,真正支撑预防性运维。


