





nginx反向代理重试需显式配置proxy_next_upstream触发条件(如error/timeout/5xx),并用proxy_next_upstream_tries和timeout限制总次数与耗时,配合upstream多节点及被动健康检查实现容错。
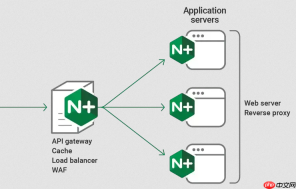
在 Nginx 中实现反向代理请求的重试策略,核心是通过 proxy_next_upstream 指令控制何时将请求转发给备用上游服务器,并配合 proxy_next_upstream_tries 和 proxy_next_upstream_timeout 限制重试行为。默认情况下 Nginx 并不会自动重试失败请求,必须显式配置才能启用。
启用基础重试条件
使用 proxy_next_upstream 指定哪些响应状态或错误会触发重试。常见组合如下:
-
error:与上游建立连接、发送请求或读取响应头时发生网络/超时错误 -
timeout:连接或响应超时(常与error一起用) -
http_500、http_502、http_503、http_504:返回对应 HTTP 状态码时重试 -
http_404等非 5xx 错误一般不建议重试(语义上表示资源不存在,换节点通常无意义)
示例配置:
location /api/ {
    proxy_pass http://backend;
    proxy_next_upstream error timeout http_500 http_502 http_503 http_504;
}
限制重试次数和总耗时
避免无限重试或长时间阻塞,需设置两个关键参数:
-
proxy_next_upstream_tries:最多尝试多少次(含首次),默认为 0(不限),建议设为 3 或 4 -
proxy_next_upstream_timeout:整个重试过程的总超时时间(从第一次请求开始计时),单位秒,默认为 0(不限),建议设为 10s 左右
注意:这两个指令作用于整个重试流程,不是单次请求超时 —— 单次超时由 proxy_connect_timeout、proxy_send_timeout、proxy_read_timeout 控制。

配合 upstream 实现多节点容错
重试机制依赖于定义多个上游服务器。Nginx 会在满足 proxy_next_upstream 条件时,按配置顺序尝试下一个可用 server(跳过 down 或健康检查失败的节点):
upstream backend {
    server 192.168.1.10:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.11:8080 max_fails=3 fail_timeout=30s;
    server 192.168.1.12:8080 backup;  # 仅当其他全不可用时才用
}
其中 max_fails 和 fail_timeout 启用被动健康检查,让 Nginx 自动标记临时故障节点,提升重试效率。
可选:启用主动健康检查(Nginx Plus 或开源版需模块)
开源 Nginx 默认不支持主动健康检查,如需定期探测后端可用性,可:
- 使用
nginx-plus的health_check指令(商业版) - 借助第三方模块如
nginx-upstream-check-module编译安装 - 或在应用层做心跳 + DNS/服务发现,由外部工具动态更新 upstream 配置
主动检查能更快剔除宕机节点,减少无效重试,但不是重试策略的必需部分。


