proxy_next_upstream_timeout 控制重试全过程的累计耗时上限,从首次请求开始计时,涵盖连接、等待、切换、重发等所有环节总和,超时即返回502/504;不设则可能因多次慢响应导致用户长时间等待。
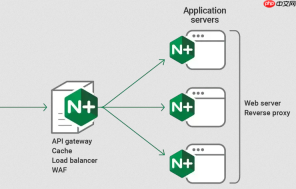
proxy_next_upstream_timeout 控制的是整个重试过程的累计耗时上限,不是单次请求超时,也不是重试次数限制。它从第一次向 upstream 发起请求开始倒计时,所有连接、等待、切换、再请求等环节的时间加起来不能超过这个值;一旦超时,Nginx 立即终止重试,返回 502 或 504。
它真正约束什么
该指令只在 proxy_next_upstream 启用且触发重试条件(如 timeout、error、http_502 等)时生效:
- ✅ 包含:首次连接建立、响应头读取失败、判定错误、选择下一个 server、新建连接、再次发送请求、再次等待响应……全部环节的耗时总和
- ❌ 不包含:客户端与 Nginx 之间的超时(由 client_header_timeout 等控制)
- ❌ 不叠加:单 backend 的 proxy_read_timeout 仍独立起作用,它只是触发重试的“开关”之一,不会因重试而延长
- ❌ 不重置:换 server 不会清空计时器,时间持续累加
为什么必须设,不设会怎样
没有总时间限制时,Nginx 可能顺序尝试所有 upstream 节点,尤其当多个后端都“慢而不死”时,用户等待会被严重拉长:
MiniMax 媒体生成
下载
一款AI音频处理工具,主要用于MiniMax统一媒体生成技能,用于TokenPlan工作流。当用户要求生成音频、语音、TTS、旁白、图片、插图、姿势等媒体内容时使用,适合需要提升相关任务效率的用户。
- 例如:upstream 有 4 台机器,proxy_read_timeout 设为 15s,proxy_next_upstream_tries 为 4
- 若每台都卡在 14.9 秒才返回 504,用户最长可能等待近 60 秒
- 而设为 proxy_next_upstream_timeout 10s,第 10 秒整就会强制终止,立刻返回错误,避免无意义干等
怎么配才合理
关键是要和 proxy_read_timeout、proxy_connect_timeout、proxy_next_upstream_tries 协同,形成梯度:
- proxy_connect_timeout 应明显小于总窗口(如设 3s),快速识别不可达节点
- proxy_read_timeout 是触发 timeout 类重试的主要依据,建议设为业务合理响应头时间(如 5–8s)
- proxy_next_upstream_timeout 推荐按 “proxy_read_timeout × 预期最大有效尝试次数” 估算并留余量,例如:
— proxy_read_timeout 5s + tries 3 → 建议设 8–12s(常用 10s)
— 若前端整体容忍上限是 30s,这个值不宜超过 20s,给 Nginx 处理和网络传输留空间 - proxy_next_upstream_tries 要配合 timeout 使用:设为 3 表示最多尝试 3 次(含首次),若前两次各耗 5s,第三次只剩不到 1s,大概率直接失败,不继续浪费时间
典型安全组合推荐
生产环境宜采用“短窗口 + 少次数”策略,兼顾容错与可控性:
- proxy_next_upstream_timeout 6s:覆盖一次 RTT + 两次处理缓冲,应对瞬时抖动足够
- proxy_next_upstream_tries 3:最多打 3 个节点(含首次),防轮空或全打慢节点
- proxy_read_timeout 5s:让慢响应快速转为 timeout,激活重试逻辑
- proxy_connect_timeout 3s:快速跳过完全失联节点
这样配置下,即使首台卡住 5 秒,Nginx 在第 5 秒末就切第二台;若第二台也卡住,到第 10 秒时总窗口已超,立即终止,不会等到第三台。