





proxy_read_timeout在长轮询中仅控制响应头发出后、响应体数据流中断的空闲等待时间,需与proxy_http_version 1.1、proxy_send_timeout、upstream keepalive协同配置,并依据后端p99挂起时长加5–10秒缓冲设定,同时对齐云负载均衡idle timeout及客户端保活策略。
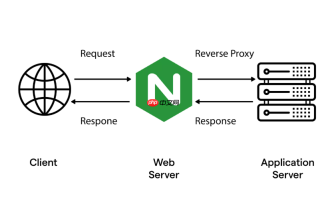
proxy_read_timeout 在大数据报表集群 + 超长轮询(Long Polling)混合场景下,不能简单“堆大值”,必须紧扣两个核心:它只管响应头发出后、数据流中断的空闲等待时间,且必须与轮询协议行为、后端挂起逻辑、客户端保活策略对齐。否则极易出现 504、连接复位、消息丢失或资源耗尽。
明确 proxy_read_timeout 在长轮询中的真实作用点
它不控制后端处理耗时,也不管客户端是否在线,只盯住一个窗口:
- 后端已返回
200 OK和完整响应头(如Content-Type: text/event-stream或application/json); - 但响应体尚未开始写入,或写入后暂停(比如等新事件、查库中、生成中间结果);
- 此期间若两次数据到达间隔超过
proxy_read_timeout,Nginx 就断连。
✅ 举例:后端用 Go 的
http.Flusher写入一个换行\n后挂起,这个\n就是“首字节响应体”,计时器立刻启动;若 30 秒内没写第二字节,Nginx 断开。
❌ 它不管后端花 10 秒才返回 header,那属于proxy_connect_timeout或后端自身逻辑。
必须同步配置的三项关键参数
单设 proxy_read_timeout 几乎必然失效,以下三者需同频调整:
proxy_http_version 1.1+proxy_set_header Connection ''
确保 Nginx 不主动关闭连接、不篡改Connection: keep-alive,让长轮询连接真正“悬停”住。proxy_send_timeout ≥ proxy_read_timeout
防止 Nginx 在向后端转发请求(如带复杂筛选条件的 JSON body)时中途超时断开,尤其当轮询请求本身也含较大 payload。upstream 块启用
keepalive 32
避免每次轮询都重建 TCP 连接。否则大量TIME_WAIT会快速占满端口,且握手延迟破坏轮询实时性。
按业务节奏设值:别拍脑袋,要留缓冲
超长轮询常见于实时报表刷新、告警推送、任务状态同步等场景,典型挂起窗口为 25–55 秒。建议按此方式设定:

安装并运行 Aperture(Lightning Labs 的 L402 闪电反向代理),用于创建 L402 付费墙、配置付费 API 端点、为其他代理托管付费内容或测试 L402 认证流程。
- 查后端监控中该接口的 P99 轮询等待时长(例如:38 秒);
- 加 5–10 秒网络与调度缓冲 → 推荐设为
45或50; -
严禁设为
0或3600:前者禁用超时易被恶意连接拖垮,后者导致 worker 连接长期积压,影响整体吞吐。
⚠️ 注意云负载均衡器(如阿里云 SLB、AWS ALB)的 idle timeout —— 若它设为 60 秒,而 Nginx 设了 50 秒,实际生效的是更短的那个。务必确认网关层一致。
客户端与后端必须协同,否则 Nginx 配再好也白搭
-
后端:
- 不要提前
WriteHeader()或Flush()空响应; - 应在真正有数据(事件、状态更新)或明确超时时,才一次性写出响应体;
- 若用 Go,推荐
context.WithTimeout(ctx, 45*time.Second)控制单次挂起,比 Nginx 值略小(如设 40s)。
- 不要提前
-
客户端:
- fetch 需禁用默认 timeout,例如
fetch(url, { signal: AbortSignal.timeout(0) }); - 若用 axios,设
timeout: 55000(比 Nginx 多 5 秒),避免前端先放弃; - 收到 502/504 后应自动重试(带指数退避),而非直接报错。
- fetch 需禁用默认 timeout,例如
不复杂但容易忽略。


