利用正则表达式提取目标数据,以便在后续请求中调用。
1、确保上一次保存的JMeter脚本处于打开状态。
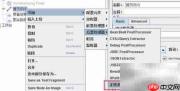
2、在目标请求节点上右键,依次选择“添加” → “后置处理器” → “正则表达式提取器”。
3、模拟访问百度首页,从服务器返回的响应体中批量识别所有以 http 开头的超链接,并逐条定位。
4、限定仅匹配含有 href 属性的 a 标签链接。
5、在配置界面中点击“正则表达式”输入框进行编辑。
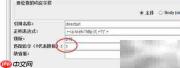
6、为便于外部引用,需为提取结果指定一个变量名。
7、关于正则语法规则本文不作深入展开,建议读者参考权威文档进一步学习。
8、该提取器支持多组匹配模式,本例中仅启用第一个匹配模板。
9、匹配数字用于指定获取第几个匹配项:0 表示随机选取一个;-1 表示提取全部匹配结果,通常与 ForEach 循环控制器协同使用。
10、正则中用圆括号包裹的部分即为实际要捕获并保存的内容。
11、通过正则匹配方式,抽取以 http 协议开头的 URL 地址。
12、启用日志记录功能,并将日志级别设为 DEBUG。
13、执行测试计划,随后查看日志输出内容。
14、确认正则表达式已准确捕获所需字段。
15、将原正则匹配编号由默认值更改为 1,表示只取第一个匹配结果,并验证其是否可正常访问。
16、新增一个 HTTP 请求采样器,在“服务器名称或IP”字段中填入变量引用格式:${directurl}。
17、运行测试,观察最终响应结果。
18、成功完成跳转请求,并成功复用前一步提取的正则结果。