轮询算法是负载均衡的基础策略,按顺序将请求均分至后端服务器,适用于性能相近节点;在多级缓存架构中,它作为接入层“节奏控制器”,配合健康检查与加权机制提升稳定性和资源利用率。
轮询算法本身不直接处理缓存,但它可以和缓存节点协同工作,形成稳定、可扩展的多级负载均衡结构。关键在于把轮询作为请求分发的“第一层节奏控制器”,再结合缓存层的特性(如局部性、命中率、一致性)做适配,而不是强行让轮询去解决缓存该管的问题。
轮询在接入层承担均匀导流角色
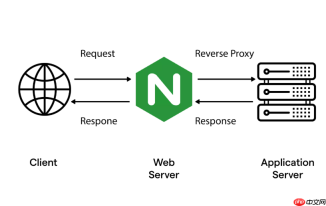
在典型的多级缓存架构中(例如:客户端 → 接入Nginx(轮询)→ 应用集群 → 分布式缓存Redis Cluster / 本地缓存),轮询主要部署在最前端的反向代理层(如Nginx upstream模块)。它的作用是把原始HTTP请求无差别地、顺序地分发到后端多个应用节点,避免某台应用服务器被突发流量打垮。
- Nginx默认启用轮询,无需额外配置权重即生效
- 每个应用节点独立对接自己的本地缓存(如Caffeine)和共享缓存(如Redis)
- 轮询不感知缓存状态,只确保请求入口流量分布均匀,为下层缓存提供稳定的请求节拍
配合缓存节点需规避“缓存倾斜”问题
纯轮询不绑定用户或请求特征,容易导致热点数据在不同应用节点上重复加载、冷热不均,进而降低整体缓存命中率。这时要靠两点补位:

- 对读多写少场景,优先使用一致性哈希替代轮询:比如在缓存代理层(如Twemproxy或自研网关)对key做hash,固定映射到某Redis分片,再配合应用层本地缓存做二级兜底
- 若必须用轮询,则在应用层强化缓存预热与淘汰策略:例如启动时批量加载高频key;使用LRU/LFU+过期时间组合,防止低频脏数据长期驻留
加权轮询提升异构缓存节点利用率
当缓存集群存在性能差异(如新老Redis节点混合部署),简单轮询会让强节点和弱节点收到相同请求数,造成资源浪费。此时可在接入层或服务发现层启用加权轮询:
- 为高配Redis Proxy节点设weight=4,老旧节点设weight=1
- Nginx配置示例:server 192.168.5.10:6379 weight=4; server 192.168.5.11:6379 weight=1;
- 注意:权重应基于实际压测结果设定,而非仅看CPU/内存规格
健康检查+轮询保障缓存链路可用性
轮询必须配合主动健康检查,否则故障缓存节点仍会持续收请求,引发雪崩。以Nginx为例,需开启对后端应用(含其依赖的缓存通道)的探测:
- 配置check inter=2000 rise=2 fall=3,每2秒探测一次
- 探测接口应真实访问下游缓存(如GET /health?cache=test),而不仅是TCP连通
- 剔除异常节点后,轮询自动在剩余健康节点间继续循环,实现静默容错