





核心是启用upstream_zone模块并配置zone指令,它通过master创建的共享内存使所有worker同步后端健康状态、连接数、哈希映射等;必须搭配max_fails和fail_timeout才能触发故障标记,且仅nginx 1.9.0+支持。
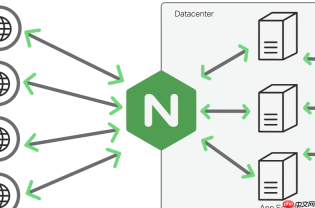
要让 Nginx 多个 worker 进程共享同一套 upstream 后端状态(比如谁健康、谁刚失败、当前连接数多少),核心就是启用 upstream_zone 模块并正确配置 zone 指令。它不是锦上添花的选项,而是解决状态隔离问题的必要基础设施。
为什么默认状态下存在“数据孤岛”
每个 worker 进程各自维护一份 upstream 状态——彼此完全隔离。一个 worker 把某台后端标记为 down,其他 worker 一无所知,仍可能把新请求发过去,造成服务中断或超时。这种隔离本质是进程级内存不共享导致的,不是配置疏漏,而是 Nginx 默认设计行为。
- 状态字段包括:节点健康状态(up/down/unavail)、失败计数(
max_fails)、上次失败时间、least_conn 算法所需的实时连接数 - 会话保持类算法(如
ip_hash或自定义hash)依赖的客户端到后端映射关系,也各自独立维护 - slow_start 阶段中权重的动态爬升进度无法跨 worker 协同,易出现流量倾斜
zone 指令如何真正打通孤岛
zone 不是缓存,而是一块由 master 进程统一创建、所有 worker 进程直接映射的共享内存区域。它通过 mmap() 分配物理内存,fork 后零拷贝继承,读写毫秒级响应,无序列化开销。

- 必须显式声明名称与大小,例如:
zone backend_zone 64k;名称用于模块间索引,大小需预估(节点数 × 每节点元数据 ≈ 1–2KB,建议从 64k 起,百节点以上可设为 1m) - 内部采用哈希表 + slab 分配器组织,关键字段(如失败计数、时间戳)使用
ngx_atomic_t类型,支持原子增减和 CAS 操作 - reload 操作会清空 zone 内容(除非配置未变更且使用特定 reload 行为),因此不适用于需持久化状态的场景
光有 zone 还不够:必须配合健康探测机制
共享内存只是载体,状态更新需要触发逻辑。仅配置 zone 不会自动标记节点为 down,必须搭配基础健康机制才能激活同步效果。
- 在
upstream块中必须设置max_fails和fail_timeout,否则连续失败不会触发状态变更 -
proxy_next_upstream的重试行为依赖 zone 中的实时状态,建议按地域调优超时值(如亚洲用户访问美国节点设为 3s,欧洲内部可压到 1s) - 若启用
keepalive或连接池,其连接数统计也纳入 zone 共享范围,确保 least_conn 算法全局准确
跨机器集群怎么办
单机多 worker 的 zone 解决不了多 Nginx 实例间的协同。此时需更高阶能力:
- NGINX Plus 提供
ngx_stream_zone_sync_module,支持节点间双向推送/拉取 zone 数据 - 通过
zone_sync_server声明对端地址,用zone_sync_interval控制同步频率(默认 1s) - 支持 TLS 加密同步(
zone_sync_ssl on),可配置证书、CA、SNI 等参数保障传输安全


