





万人在线聊天室需 WebSocket 专用代理(如 Envoy)、Redis Pub/Sub 跨节点广播、客户端无感重连及系统资源调优。
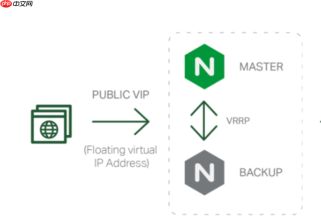
要让万人在线聊天室稳定运行,光靠单台 WebSocket 服务器远远不够。流量调度的核心不是“转发请求”,而是**统一连接管理 + 消息广播协同 + 客户端无感切换**。WebSocket 本身不支持传统 HTTP 那样的反向代理负载均衡(比如 Nginx 直接 proxy_pass 到多个 ws 后端),必须配合专用代理层和状态同步机制。以下是关键实现路径:
用 WebSocket 专用代理做连接入口
不能用普通 HTTP 反代工具直接转发 WebSocket 升级请求——它需要透传 Upgrade 和 Connection: Upgrade 头,并维持长连接生命周期。
- Nginx 1.13.12+ 支持 WebSocket 代理,需显式配置:
location /ws {
proxy_pass http://backend;
proxy_http_version 1.1;
proxy_set_header Upgrade $http_upgrade;
proxy_set_header Connection "upgrade";
proxy_read_timeout 86400;
} - 更推荐使用 HAProxy 或 Envoy:它们原生支持 WebSocket 连接保持、健康检查、会话粘性(sticky session)等能力,能按 IP 或 Cookie 做一致性哈希,避免用户频繁重连
- 代理层不处理业务逻辑,只做连接接入、心跳透传、异常断连检测与自动摘除故障节点
用 Redis Pub/Sub 实现跨节点消息广播
用户 A 连在 Server-1,用户 B 连在 Server-2,他们必须能互相收消息——这要求所有后端节点共享“消息总线”。
- 每个 WebSocket 服务节点启动时,订阅同一个 Redis 频道(如 chat:global)
- 用户发消息 → 当前节点解析后,不只推给本地在线用户,同时 PUBLISH 到 Redis 频道
- 所有节点收到 Redis 消息后,将内容分发给各自管辖的 WebSocket Session
- 注意:Redis 不保证消息顺序或 100% 不丢,生产环境建议搭配 Kafka 或 RocketMQ 做可靠消息中转(尤其对“系统通知”“进退场提示”等强一致性场景)
客户端配合实现无感重连与状态恢复
代理或后端宕机时,用户不该看到“连接已断开”,而应自动切到可用节点并续上聊天上下文。

WebSocket 8.18.2
下载
WebSocket 8.18.2 是该协议规范的一个重要迭代版本,主要优化了连接稳定性与数据传输效率。它通过全双工通信机制,允许客户端与服务器在单一长连接上实时交换数据,大幅降低传统 HTTP 轮询的开销。该版本增强了心跳保活、自动重连及二进制帧传输能力,适用于即时通讯、在线游戏及金融行情推送等低延迟场景,为开发者提供更可靠的实时网络交互基础。
- 前端 WebSocket 连接需封装重连逻辑:指数退避(1s→2s→4s…),最大重试 5 次
- 首次连接成功后,服务端返回唯一 connectionId 和当前 seqNo(消息序号),前端缓存
- 重连时带上 connectionId 和最后收到的 seqNo,后端可从 Redis 或数据库拉取断连期间的离线消息补推
- 昵称、头像、未读数等轻量状态建议存在 localStorage,避免重连后重新输入
补充:连接数瓶颈不在带宽,而在内存与文件描述符
单机支撑万人在线,关键不是 CPU,而是操作系统资源限制和 JVM 参数调优。
- Linux 调整:
ulimit -n 100000、net.core.somaxconn=65535、关闭tcp_tw_reuse防 TIME_WAIT 爆满 - Netty 或 Spring Boot WebSocket 服务需设置:
bossGroup 线程数 = 1(只管 accept)
workerGroup 线程数 = CPU 核数 × 2
SO_BACKLOG = 1024
禁用 Nagle 算法(tcpNoDelay = true) - 每个 WebSocket 连接约占用 10–15KB JVM 堆内存,万人即 100MB+,建议堆内存设为 2–4GB 并启用 G1GC


