





避免无限重试需同时设tries上限、timeout总耗时限制及健康检查剔除坏节点;tries=3表示共尝试3次(含首次),timeout应略大于单次响应时间且不超proxy_read_timeout,必须配合主动/被动健康检查与幂等语义控制。
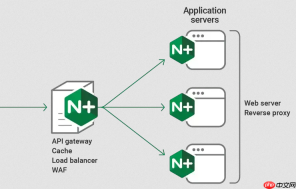
要避免请求在集群内无限重试,关键不是把 proxy_next_upstream_tries 设得更大,而是给重试行为设硬性边界:明确次数上限、绑定总耗时限制、剔除不可用节点三者必须同时生效。
明确tries是总尝试次数(含首次)
该指令控制的是单次请求生命周期内最多转发多少次,不是“额外重试几次”。设为 3 表示:第 1 次发给原始节点,失败后最多再换 2 个节点各试一次(或同一节点多次,若它未被踢出)。常见误区与建议:
- 设为 0 是默认值,等于无限重试,生产环境绝对禁止
- 设为 1 = 禁用重试,适合订单提交、支付回调等非幂等操作
- 设为 3 是最常用安全值,覆盖瞬时抖动,又不显著放大负载
- 设为 ≥5,尤其 upstream 节点少于 3 台时,极易反复打向同一台故障机器
必须搭配 proxy\_next\_upstream\_timeout 控制总窗口
只限次数不管时间,等于纵容慢节点。timeout 是从第一次请求发起开始计时的**整体耗时上限**,超时即刻终止所有后续尝试并返回错误(如 502),不等第三次响应。

aperture: the L402 aware reverse proxy
下载
安装并运行 Aperture(Lightning Labs 的 L402 闪电反向代理),用于创建 L402 付费墙、配置付费 API 端点、为其他代理托管付费内容或测试 L402 认证流程。
- 若单次合理响应约 3 秒,
proxy_next_upstream_timeout建议设为 6–10 秒(例如 8s) - 若
proxy_read_timeout是 5 秒,timeout 不宜超过 12 秒,否则第三次尝试可能只剩不到 1 秒 - 单独设
tries 5但timeout 30s,前两次各耗 15 秒,第三次根本没机会执行 - timeout 不能比 proxy_read_timeout 还小,否则首次请求就可能被截断
重试前先剔除坏节点:健康检查不能缺位
没有健康检查,proxy_next_upstream_tries 再小也白搭——Nginx 会不断把请求发给已失联或假死的节点,形成无效循环。
- 在 upstream 块中启用主动探测:
health_check interval=3 fails=2 passes=2; -
check_http_expect_alive只认 2xx/3xx,避免把 503 当作存活 - 配合被动摘除:
max_fails=2 fail_timeout=30s,让失败能快速下线节点 - 健康检查间隔不宜 >10s,fails 不宜 ≥5,否则宕机节点会长期滞留
按请求语义决定是否允许重试
重试本质是风险放大器。高并发下一次失败立刻转给另一台机器,等于把压力复制 2–3 倍。
-
GET 类查询可谨慎开启:
proxy_next_upstream error timeout http_502 http_503 http_504 -
POST/PUT/DELETE 默认不重试;强行加
non_idempotent必须由业务层 100% 保障幂等(如带唯一请求 ID + 服务端去重) - 绝对不要加
http_404、http_403、http_500——它们多属业务错误,重试无意义,还可能重复扣款或生成重复订单


