





down指令需紧贴server地址端口后、分号前,如server 192.168.1.10:8080 down;,平台须据此识别并驱动连接数平滑下线全流程。
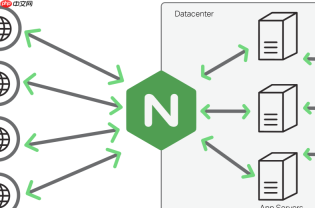
用 down 指令配合自动化运维平台实现连接数平滑下线,核心是把人工四步操作(标记 → reload → 观察 → 停服)变成可编排、可验证、可回滚的自动流程。关键不在“能不能加 down”,而在于“加完之后平台是否知道该等什么、查什么、何时下一步”。
down 指令必须写对,平台才能可靠识别
自动化平台读取或生成 Nginx 配置时,必须严格遵循语法规范,否则 reload 失败或行为异常:
- down 必须紧贴在 server 地址和端口之后、分号之前,例如:
server 192.168.1.10:8080 down; - 不能与 max_fails、fail_timeout 等参数混写在同一行,否则 nginx -t 校验失败
- 不能换行写,也不能写成
server ...; down;这类无效格式 - 建议平台配置模板中统一用占位符(如
{{ node_ip }}:{{ port }} {{ status_flag }}),上线时注入down或空字符串,避免硬编码错误
平台需主动监控连接衰减,而非只看 reload 成功
reload 完成只代表流量不再进入,不代表下线完成。平台必须持续采集并判断连接是否自然归零:
- 调用目标节点的
ss -tn state established | grep :8080 | wc -l,每 5–10 秒轮询一次,直到连续 2 次返回 0 - 若使用 Nginx stub_status,可检查
Active connections及Reading/Writing/Waiting数值趋势 - 对接应用健康接口(如
/health?ready=false),确认其已主动关闭新连接入口 - 超时兜底:设置最大等待时间(如 300 秒),超时未清零则告警并暂停后续步骤
与运维平台动作链深度集成,形成闭环
down 不是孤立指令,需嵌入完整生命周期流程中:
-
前置检查:平台执行前,先调用
nginx -t验证配置,再检查目标节点是否已在 upstream 中存在(防误标) -
标记与生效:修改配置后执行
nginx -s reload,记录 reload 时间戳,并触发下游通知(如钉钉/企微机器人) - 状态同步:将该节点标记为 “downing” 状态,写入 CMDB 或服务注册中心(如 Consul 的 kv 存储),供其他系统感知
- 恢复联动:维护完成后,平台自动删掉 down 关键字、reload,并调用应用健康检查确认就绪,再将状态切回 “up”
搭配 backup 节点实现自动流量接管
单靠 down 会丢流量,平台应支持主备协同策略:
- 提前在 upstream 中配置好 backup 节点,如:
server 192.168.1.100:8080 backup; - 平台执行 down 主节点时,可同步触发 backup 节点的预热(如发送若干 probe 请求),避免冷启动延迟
- 若检测到主节点 down 后 backup 流量突增但响应延迟升高,平台可自动告警并暂停后续下线批次
- 不推荐动态改 weight 实现渐进下线——ip_hash 不支持 weight,且权重调整无法保证连接自然结束


