





要实现nginx与后端微服务优雅下线协同,需让后端主动退场(返回503)、nginx主动避让(健康检查提前摘除)、重试仅兜底(精准配置proxy_next_upstream并限制触发边界),配合draining时间窗和实测验证确保零报错、无感割接。
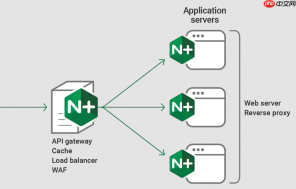
要让后端微服务在优雅下线过程中,Nginx 的 proxy_next_upstream 真正做到零报错、无感割接,关键不是堆参数,而是让“下线动作”和“Nginx 容错机制”形成节奏一致的协同:后端主动退场,Nginx 主动避让,重试只兜底不抢跑。
让 Nginx 提前感知,别等失败才反应
proxy_next_upstream 是失败后的 fallback,不能替代前置规避。必须配合健康检查,把“即将下线”的节点提前摘出调度池:
- 后端暴露
/health?ready=false或/actuator/health返回503 Service Unavailable,并确保该路径不被业务逻辑拦截 - Nginx upstream 中启用主动健康检查(OpenResty 或 Nginx Plus)或配置被动检查:
server 10.0.1.10:8080 max_fails=1 fail_timeout=5s;,让单次 503 就快速标记为不可用 - 避免依赖 reload 配置——每次改 weight 或删节点都 reload 会中断长连接;推荐用 Lua 脚本(如
resty.upstream.healthcheck)或注册中心联动(Consul/Nacos + confd)热更新 upstream
精准控制 proxy_next_upstream 的触发边界
默认它不处理 502/503/504,必须显式声明,且仅限可安全重试的场景:

CPA Update - Secure CLI Proxy API Maintenance
下载
安全更新和维护 CLI Proxy API(CPA)部署与配置。用于 CPA 镜像升级、配置变更、认证目录兼容修复、上线验证与回滚。适用于用户提到“CPA 更新/升级/配置改了/容器重建/回滚”等场景。
- 在 location 块中写全关键类型:
proxy_next_upstream error timeout http_502 http_503 http_504 invalid_header; - 禁用
http_500和http_404:前者常是业务异常,后者是路径问题,重试无意义还可能重复扣款 - GET/HEAD 请求默认可重试;若需对 POST 重试,必须确认后端已实现幂等(如基于
X-Request-ID去重),并在 Nginx 1.9.13+ 中加non_idempotent参数
设好 draining 时间窗,给连接自然收尾
优雅下线的本质是“停新不杀旧”,Nginx 需配合留出缓冲期:
- 后端开始下线前,先返回 503 并停止接受新连接(如 Spring Boot 中调用
/actuator/refresh或关闭 Tomcat acceptor) - Nginx 层设置
proxy_read_timeout 60s;,并确保proxy_next_upstream_timeout≥ 60s(例如设为 75s),容得下存量请求走完 - 通过
stub_status或nginx-module-vts监控Active connections和Reading/Writing/Waiting数值,确认归零后再终止进程 - 开启
proxy_ignore_client_abort on;,防止用户关页面导致 Nginx 中断后端长响应
验证是否真无感,别信日志信实测
配置写完不等于生效,必须用真实链路验证:
- 在 upstream server 响应头中注入标识:
add_header X-Upstream-Node "node-a";,用 curl -v 多次请求,观察是否自动切到其他节点且状态码始终是 200 - 临时将某节点设为 503,抓包看客户端是否收到一次 503 后立刻重试成功——如果没切,检查 health_check 是否启用、max_fails 是否生效、proxy_next_upstream 是否写在正确 location 下
- 打开 Nginx error log 的 debug 级别,搜索
"next upstream",确认日志中出现切换原因(如upstream timed out或upstream sent no valid HTTP/1.0 header)


