





nginx中“事件循环入口”实指请求首经的http块全局限流区及server/location拦截点,是漏桶算法生效起点;通过$binary_remote_addr+map按ua精准识别爬虫并限流,结合$request_uri防护静态资源刷量,关键调优rate、burst、nodelay参数,并启用日志验证效果。
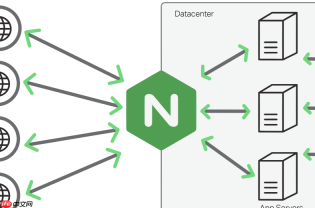
在 Nginx 中,“事件循环入口”并不是一个标准术语,实际指的是请求刚进入 Nginx 的第一处理层——即 http 块定义的全局限流区 + server 或 location 块中启用的拦截点。这里正是漏桶算法生效的起点:所有匹配规则的请求,在被路由、转发或执行业务逻辑前,先经过 limit_req 的速率检查。对高频爬虫而言,越早拦截,资源消耗越少,防护效果越直接。
用 $binary_remote_addr + map 实现精准爬虫识别与限流
单纯按 IP 限流容易误伤(如企业出口 NAT)或漏掉分布式爬虫;更可靠的方式是结合 User-Agent 特征做动态 key 分类:
- 在
http{}块顶层定义map,将常见爬虫 UA 映射为统一标识,非爬虫则 fallback 到 IP:
~*baiduspider "spider_baidu";
~*yandexbot "spider_yandex";
~*googlebot|mediapartners "spider_google";
default $binary_remote_addr;
}
- 基于该变量定义限流 zone,速率设得比正常用户低得多(例如每分钟 100 次):
- 在
server或根location /中启用,确保所有请求都过这一关:
limit_req zone=crawler_limit burst=5 nodelay;
limit_req_status 429;
# 后续 proxy_pass 或 try_files...
}
针对静态资源路径强化防护(防带参刷图/JS)
很多爬虫不攻击接口,专刷 /logo.png?v=123、/app.js?t=456 这类带缓存绕过的 URL。用 $request_uri 而非 $uri 才能真正区分它们:

- 定义 zone 时保留完整 URI(含 query string):
- 只在静态资源 location 中启用,避免影响动态接口:
limit_req zone=static_burst burst=10 nodelay;
expires 1y;
}
- 若发现同一资源被多 IP 集中刷(如 CDN 回源放大),可升级为组合 key:
"$binary_remote_addr$request_uri",内存开销略增但精度更高。
关键参数调优要点
漏桶不是“开关”,而是持续调节的水阀。以下参数决定拦截是否有效且不伤业务:
-
rate:基础出水速率。爬虫限流建议用
r/m单位(如200r/m),比r/s更平滑,避免秒级毛刺误判 -
burst:桶容量。设为
5~10足够应对页面首次加载的并发资源请求,过大则削弱防护 - nodelay:必须开启。否则漏桶会排队延迟请求,攻击者可用慢速连接耗尽队列,变相绕过限制
- zone 大小:10MB zone 约支持 16 万个独立 key。爬虫 key 若过多(如大量随机 UA),优先保核心 UA,其余 fallback 到 IP
验证与可观测性配置
不验证的限流等于没配。加两行就能确认是否真起作用:
- 在
http{}块中打开详细日志:
'$status $body_bytes_sent "$http_referer" "$http_user_agent" '
'limiting: $limiting;
access_log /var/log/nginx/limit_access.log limit_log;
- 重启后用 ab 或 curl 模拟爬虫行为:
- 检查日志中是否出现
limiting: "crawler_limit"和大量429响应


