





数组实现错误日志缓冲区采用“固定长度+循环覆盖”,用writeindex%capacity定位写入位置,覆盖旧日志以节省内存并保留最新有效日志;读取时需按环形顺序分段slice并concat拼接,确保时间序正确。
用数组实现错误日志缓冲区,核心是“固定长度 + 循环覆盖”,既节省内存又保留最新错误。关键不是存得全,而是留得准——系统出问题时,最后几条日志往往最能定位根因。
用定长数组模拟环形缓冲区
声明一个固定大小的数组(如 100 条),配合一个写入索引 writeIndex。每次写新日志时,直接覆写 array[writeIndex % capacity],再递增索引。无需移动旧数据,也不用扩容缩容。
- 初始化:let logs = new Array(100); let writeIndex = 0;
- 追加日志:logs[writeIndex % logs.length] = `[${new Date().toISOString()}] ${msg}`; writeIndex++;
- 读取全部有效日志(按时间顺序):logs.slice(0, Math.min(writeIndex, logs.length)) 或更准确地按环形顺序拼接(见下条)
按时间顺序读取:处理“绕圈”情况
当 writeIndex ≥ 数组长度,日志已开始覆盖,此时真实数据分布在数组尾部和头部两段。需分段提取并合并:
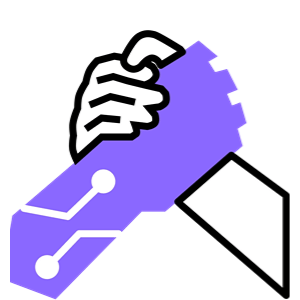
- 若 writeIndex :直接返回 logs.slice(0, writeIndex)
- 否则(已循环):返回 logs.slice(writeIndex % logs.length).concat(logs.slice(0, writeIndex % logs.length))
实战中覆盖变量旧记录的典型场景
常见于前端监控、嵌入式设备日志、服务中间件等资源受限环境。例如:
-
前端异常捕获:全局监听
window.onerror,每条错误连同堆栈、URL、UA 写入日志数组,用户提 bug 时一键导出最后 50 条 - Node.js 中间件:在请求链路中遇到校验失败或 DB 超时,不抛错而是记一条结构化日志到缓冲区,避免 I/O 阻塞主线程
- 覆盖关键状态变量:不只是日志文本,也可缓冲对象,如 lastError = { code: 500, traceId: 'abc', timestamp: Date.now() },后续同名赋值自动覆盖,确保只留最后一次上下文
小技巧:带序号与快速检索
为便于调试,可在每条日志前加逻辑序号(非数组下标),或额外维护一个 idCounter;需要按关键词查日志时,遍历当前有效区间即可,不用扫全量数组:
- logs.forEach(log => log?.includes('timeout') && console.warn('发现超时:', log))
- 避免用 logs.filter(...) 全量筛选——它会遍历整个数组(含 undefined 占位项),应先提取有效日志再操作





