





原生nginx不支持主动健康检查,需依赖nginx_upstream_check_module模块;可通过nginx -v命令验证是否启用,未启用时可重新编译或改用openresty;配置示例含interval、rise、fall等参数;支持http/head探测及/status监控页面;建议禁用max_fails避免冲突。
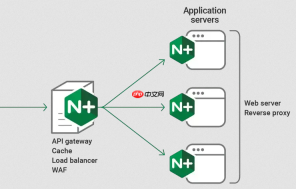
原生 Nginx(开源版)不支持对 upstream 服务器做主动、持续的心跳探测(即定期发 HTTP/HTTPS/TCP 请求判断后端是否存活),只提供被动检查(如连接失败、超时、返回 5xx 后标记为 down)。要实现真正的主动健康检查,需借助第三方模块——最常用且成熟的是 nginx_upstream_check_module。
确认 Nginx 是否已编译该模块
该模块非官方内置,需在编译 Nginx 时显式添加。若你使用的是系统包管理器安装的 Nginx(如 apt/yum 安装的 nginx-full 或 nginx-plus),默认不含此模块。可执行以下命令快速验证:
nginx -V 2>&1 | grep -o 'upstream_check'
无输出即未启用。此时有两个选择:
- 重新编译 Nginx:下载对应版本源码,加入
--add-module=/path/to/nginx_upstream_check_module - 改用 OpenResty:它默认集成该模块,且兼容 Nginx 配置语法,升级成本低
配置主动健康检查(HTTP 模式)
在 upstream 块中启用 check 指令,并指定探测方式。示例:

upstream backend {
    server 192.168.1.10:8080;
    server 192.168.1.11:8080;
    check interval=3 rise=2 fall=5 timeout=1;
    check_http_send "HEAD /health HTTP/1.0\r\n\r\n";
    check_http_expect_alive http_2xx http_3xx;
}
关键参数说明:
-
interval=3:每 3 秒探测一次 -
rise=2:连续 2 次成功则恢复为 up 状态 -
fall=5:连续 5 次失败则标记为 down -
timeout=1:单次探测超时 1 秒 -
check_http_send:发送自定义 HTTP 请求头,建议用 HEAD 避免传输响应体 -
check_http_expect_alive:指定哪些状态码视为健康(如仅 200 可设为http_2xx)
暴露检查状态供监控与调试
模块提供内置 status 页面,用于实时查看各节点健康状态和统计信息。添加一个 location 即可:
location /status {
    check_status;
    # 可选:加 basic auth 或限制 IP 访问
    allow 127.0.0.1;
    deny all;
}
访问 http://your-nginx-ip/status 将看到表格化输出,含 IP、Port、Status、Rise、Fall、Check Count、Check Time 等列,便于排查节点异常或网络抖动问题。
注意与原生 max_fails/fail_timeout 的兼容性
若 upstream 中同时配置了 max_fails 和 fail_timeout,它们与 check 模块共存时会并行工作,但优先级以 check 模块为准。建议:
- 禁用原生被动检查:移除
max_fails和fail_timeout,避免逻辑冲突 - 确保后端服务提供轻量
/health接口(如返回 200 OK,无业务逻辑、不查 DB) - 若后端是 gRPC 或非 HTTP 服务,该模块不支持;可改用 TCP 检查(
check_type=tcp),但无法校验业务层可用性


