





max_conns是阻断后端雪崩向网关传导的关键熔断机制,通过限制单节点最大连接数,配合least_conn/ip_hash策略、keepalive连接池及≥1.11.5版本,实现连接级故障隔离。
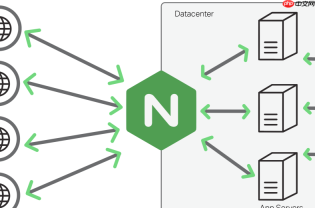
限制 max_conns 是缓解后端雪崩向网关反向传导、避免集群网关挂起的关键控制手段之一。它不解决雪崩根源,但能切断“请求持续涌向已失能节点→连接堆积→Nginx worker 被占满→新请求排队或超时→网关整体响应迟滞甚至假死”这一恶性循环。
max_conns 如何阻断雪崩传导链
当某台后端服务因故障或过载响应变慢甚至无响应时:
- Nginx 默认(round_robin)会继续轮询该节点,不断建立新连接,导致连接在该节点上堆积、超时、重试
- 若未设
max_conns,Nginx 可能为这台“半死”节点维持数十甚至上百个等待响应的长连接,耗尽本地连接池和 worker 连接槽位 - 一旦大量 worker 被卡在等待上游响应上,就无法处理新请求,表现为网关吞吐骤降、延迟飙升、
upstream timed out日志激增,形成“挂起”假象 - 启用
max_conns后,Nginx 在连接数达到阈值时会主动跳过该节点,将新请求分发给健康节点——相当于给每台后端加了一道“连接熔断阀”
必须配套生效的三项配置
max_conns 不是开关式参数,缺一不可:
-
负载策略必须为
least_conn或ip_hash:只有这两种策略会在选节点前检查max_conns余量;round_robin完全忽略该参数 -
必须启用
keepalive连接池:例如keepalive 32;,否则短连接下连接瞬时建立又释放,max_conns无法形成有效约束 - Nginx 版本 ≥ 1.11.5:低版本直接无视该参数,配置无效
合理设置 max_conns 数值的依据
数值不是拍脑袋定的,需结合后端真实承载能力:
- Java 应用参考 Tomcat 的
maxThreads,设为它的 70%~90%(例如 maxThreads=200 → max_conns=140~180) - Go/Node.js 等轻线程模型可适当提高,但仍建议预留 20% 余量应对突发
- 若后端自身启用了连接池(如 HikariCP),要扣除其内部数据库连接占用(例如 HikariCP
maximumPoolSize=20,则留给 HTTP 请求的并发应 ≤ 160) - 配合
proxy_next_upstream error timeout http_502 http_503 http_504,确保上游返回错误时能及时重试其他节点
搭配健康检查才真正防僵局
仅靠 max_conns 不能替代故障感知。必须叠加主动探测机制:
- 为每个
server加上max_fails=2 fail_timeout=15s,让 Nginx 在连续失败后主动剔除异常节点 - 在
location块中启用proxy_next_upstream_tries 3和proxy_next_upstream_timeout 3s,避免单次重试拖垮整个请求链 - 定期通过
$upstream_addr日志分析是否频繁出现 “no live upstreams”,这是配置失效或后端大面积失联的明确信号


