





真正有效的多机房容灾方案需结合权重控制、健康检查与地理感知:按实测QPS设定差异化权重,启用主动健康检查实现自动故障隔离,并用geo指令支持地域优先路由,最后通过压测、故障模拟与灰度发布验证效果。
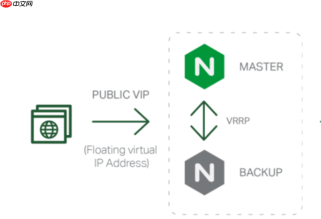
多机房容灾中单纯靠“平均分配”流量,往往导致本地机房过载、异地机房闲置,甚至故障切换不及时。真正有效的方案,是结合权重控制、健康检查与地理感知逻辑,在保障业务连续性的同时实现资源利用率最优化。
按机房能力设定差异化权重
不同机房的服务器配置、带宽、延迟差异明显,不能简单按数量均分。比如主中心(A机房)有8台高性能服务器,灾备中心(B机房)只有4台中配机器,直接轮询会导致B机房很快饱和。
- 给A机房每台服务器设 weight=3,B机房设 weight=1,整体权重比约为 24:4 → 6:1
- 若需B机房承担10%~15%流量用于常态化验证,可微调为 weight=2,再配合 max_fails=2 fail_timeout=30s 避免误剔
- 权重不是固定值——上线前用 ab 或 wrk 压测各机房单节点吞吐,按实测 QPS 反推合理 weight 比例
启用主动健康检查+自动故障隔离
跨机房网络抖动频繁,仅靠被动检测(如连接超时)响应太慢。必须开启主动探测,让Nginx自己定期“敲门”确认服务可用性。

- 在 upstream 中为每个 server 加上 max_fails=3 fail_timeout=20s,并配合 health_check interval=5 rise=2 fall=3(需 nginx-plus 或开源版 + lua 模块)
- 对B机房的探测路径建议走独立健康接口(如
/health?site=backup),避免和主业务共用路径造成误判 - 探测失败后,Nginx 会临时从调度池移除该节点;恢复后自动加回,无需人工干预
用 geo 指令做地域优先路由(可选增强)
对用户敏感型业务(如支付、订单),可让同一区域用户优先落在本地机房,降低跨中心延迟,同时保留灾备兜底能力。
- 在 http 块中定义 geo $region,根据 $remote_addr 匹配 IP 库识别用户属地
- 通过 map 将 $region 映射为 upstream 名称(如 cn_beijing → backend_bj,cn_shanghai → backend_sh)
- 在 server 块中用 set $upstream_name ... + proxy_pass http://$upstream_name 实现动态上游选择
- 所有 upstream 都包含两地节点,但默认只启用本地组;当本地全挂时,fallback 到全局 backup 组
验证与灰度发布关键点
配置写完不等于生效,尤其跨机房场景下,必须验证真实流量走向与故障模拟效果。
- 用 curl -H "Host: test.example.com" http:///status 查看 Nginx stub_status,确认各 upstream 的 requests 分布比例
- 手动停掉A机房一台服务,观察 access_log 中对应IP的请求是否在10秒内全部切到B机房节点
- 灰度阶段先对内部测试流量(如 UA 含 testbot)开放B机房1%权重,再逐步扩至5%、10%,同步监控错误率与P95延迟
- 记录每次变更的 upstream hash 值(可通过 md5sum /etc/nginx/conf.d/*.conf),便于快速回滚


