





支撑万人在线需构建websocket高可用集群,核心是分层解耦:接入层用nginx/envoy做无状态网关并启用sticky session;分发层通过redis pub/sub实现跨worker精准广播;状态层用redis cluster统一存储会话与房间元数据,保障状态一致性和故障恢复能力。
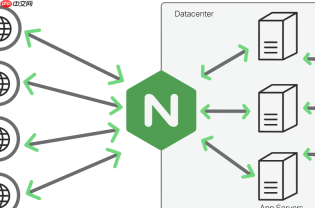
要支撑万人在线,单台 WebSocket 服务器很快会遇到连接数、内存、CPU 和广播性能瓶颈。高可用集群不是简单加机器,而是需要分层解耦、状态分离与流量可控。核心思路是:把连接管理、消息路由、状态存储、会话同步拆到不同角色中,再通过合理的拓扑组织起来。
接入层:无状态 WebSocket 网关
这是用户最先接触到的节点,负责 TLS 终结、连接握手、心跳保活和基础鉴权。它本身不存用户状态或聊天室数据,只做协议转换与负载分发。
- 推荐用 Nginx + WebSocket 模块 或 Envoy 做四层/七层负载,开启 sticky session(基于 Cookie 或 IP 哈希),确保同一用户的后续帧始终打到同一个网关实例
- 每个网关实例后接多个应用 Worker(如 Spring Boot 或 Egg.js 的 App Worker),Worker 数量建议设为 CPU 核数的 1.5–2 倍
- 禁用网关缓存,关闭重试机制——WebSocket 是长连接,失败应由客户端重连逻辑处理,而非网关反复转发
消息分发层:中心化广播总线
当用户 A 在“技术讨论”房间发消息,所有在该房间的用户(可能分散在不同 Worker 上)都需收到。这就需要一个跨进程、跨机器的消息通道。

WebSocket 8.18.2
下载
WebSocket 8.18.2 是该协议规范的一个重要迭代版本,主要优化了连接稳定性与数据传输效率。它通过全双工通信机制,允许客户端与服务器在单一长连接上实时交换数据,大幅降低传统 HTTP 轮询的开销。该版本增强了心跳保活、自动重连及二进制帧传输能力,适用于即时通讯、在线游戏及金融行情推送等低延迟场景,为开发者提供更可靠的实时网络交互基础。
- Redis Pub/Sub 是最轻量且成熟的选择:Worker 收到消息后 publish 到 room:tech 频道,所有订阅该频道的 Worker 实时收到并推送给本地连接的对应用户
- 若需更高吞吐或消息持久化(如离线补推),可升级为 Kafka 或 Pulsar,但会增加运维复杂度
- 注意避免“广播风暴”:不要对全站用户 broadcast,而是按 room ID 或 user group 精准发布;大群聊可结合 Redis Hash 存储当前在线成员,只推给活跃连接
状态管理层:分布式会话与房间元数据
谁在哪个房间?谁在线?最后心跳时间?这些信息不能只存在某台机器内存里,否则扩缩容或故障时状态丢失,导致“用户已下线却还显示在线”等问题。
- 用 Redis Cluster 存储两类关键数据:一是用户连接映射(如 conn:uid123 → worker-02:session-id),二是房间成员列表(如 room:tech → set(uid123, uid456))
- 所有 Worker 在用户加入/退出房间时,统一操作 Redis,配合 Lua 脚本保证原子性;定时任务扫描过期心跳(如 90 秒无 ping),自动清理离线用户
- 避免用数据库存实时连接状态——MySQL 或 PostgreSQL 的写入延迟和连接池压力会成为瓶颈
扩展与容灾设计要点
集群不是堆机器,而是让每部分都能独立伸缩、故障隔离。
- 横向扩容优先级:先加网关和 Worker,再按消息压力加 Redis 分片,最后才考虑消息中间件扩容
- 同城多机房部署时,用 Redis Global Cache(如阿里云 Tair 或自建 CRDT Redis)同步核心元数据;跨城场景则建议按地域划分聊天室,避免远距离广播延迟
- 每个 Worker 启动时向注册中心(如 Nacos 或 Etcd)上报自身负载指标(连接数、CPU、内存),网关据此做动态权重调度,而非简单轮询


