





504错误本质是反向代理与后端服务间超时契约失衡或通信异常,需通过nginx错误日志定位超时阶段(如upstream timed out)、比对后端访问日志确认请求抵达情况、校准proxy_read_timeout等参数匹配实际业务耗时,并排查cdn/waf/ingress等链路中间件干扰。
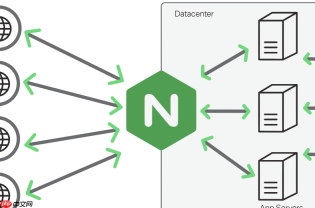
504 错误本身不说明后端崩溃,而是暴露了反向代理(如 Nginx)与后端服务之间的时间契约失衡或通信异常。真正的问题往往藏在日志的「时间差」和「行为断层」里——不是看有没有错,而是看“谁在等谁、等了多久、等到了什么”。
查 Nginx 错误日志,锁定超时类型
Nginx 的 /var/log/nginx/error.log 是第一现场。重点关注含 upstream timed out 的行,它会明确指出超时发生在哪个阶段:
- while reading response header from upstream:Nginx 连上了后端,但连响应头都没收到——后端可能卡在启动、鉴权、数据库连接池耗尽,或根本没进业务逻辑;
- while reading upstream:响应头已收到,但 body 流式返回太慢或中断——常见于大文件下载、未分页的海量数据查询、同步日志写入阻塞;
- while connecting to upstream:这不是 504,是 502;若误判为 504,说明日志解析有偏差,需核对错误码字段。
比对后端访问日志,确认请求是否抵达
拿到 Nginx 日志中报错时间点(精确到秒),立即去查后端服务的 access log(如 Node.js 的 pino 日志、Java 的 access.log 或 Spring Boot 的 request log):

- 如果后端日志里完全没有对应时间戳的请求记录:问题在 Nginx 到后端的网络层(防火墙拦截、Service Mesh sidecar 故障、K8s Endpoints 异常、DNS 解析失败);
- 如果后端日志里有请求开始,但无结束或耗时远超 proxy_read_timeout:说明后端处理慢,需结合应用监控(如慢 SQL、线程阻塞、GC 停顿)进一步下钻;
- 如果后端日志显示请求已成功返回,但 Nginx 仍报 504:大概率是 Nginx 缓冲区配置不当(如 fastcgi_buffer_size 过小导致响应被截断重试)或启用了 proxy_buffering off 后流式响应不稳定。
检查超时参数与业务实际耗时的匹配度
Nginx 默认的 proxy_read_timeout 60s 是通用值,不是金科玉律。需用真实请求耗时分布来校准:
- 用 APM 工具(如 SkyWalking、Datadog)统计后端接口 P95/P99 响应时间,若普遍在 45–55s,那 60s 就极易误杀;建议设为 P99 + 10s,并对长耗时接口单独用 location 块配置更高超时;
- 注意 proxy_connect_timeout 和 proxy_send_timeout 不能盲目拉长——前者过长会让故障发现延迟,后者过长可能堆积无效发包;
- 若后端是 PHP-FPM,还需同步检查 request_terminate_timeout 是否小于 Nginx 的 fastcgi_read_timeout,否则后端先杀进程,Nginx 还在等,最终报 504 而非 502。
识别链路中隐藏的中间件干扰
现代架构常有多层代理(CDN → WAF → Nginx → Service Mesh → 应用),504 可能来自任意一层:
- 查看响应头中的 X-Request-ID 或自定义 trace-id,贯穿全链路日志,确认是哪一层返回了 504;
- 云厂商 WAF(如阿里云 Anti-Bot、Cloudflare)可能自带 30s 网关超时,且不透传真实上游错误,需登录控制台查 WAF 访问日志;
- K8s Ingress Controller(如 nginx-ingress、Traefik)也有独立超时配置,优先级高于 Nginx 自身配置,容易被忽略。


