





近日,蚂蚁灵波科技联合香港科技大学等高校完成的研究成果《causal world modeling for robot control》正式被国际机器人领域顶级会议 robotics: science and systems(rss)2026录用。
RSS 是全球机器人学界最具权威性的学术会议之一,聚焦机器人学习、感知、控制、规划及系统集成等核心方向,以评审严苛、录取率低著称。该论文的入选,标志着其在理论创新性与技术落地性两方面均获得国际机器人学术共同体的高度肯定。
本研究的核心目标,是赋予机器人超越“被动响应”的能力——使其能在执行动作前,主动推演该动作将引发的环境状态变化。为此,团队构建了面向机器人控制的因果世界建模范式,并基于此推出全球首个开源自回归视频-动作世界模型 LingBot-VA。该模型在任务运行中持续进行视觉动态预测,并据此实时生成最优动作序列,从而实现“观察—预测—决策—执行”的闭环智能流程,逼近人类“边看、边想、边做”的认知行为模式。
对蚂蚁灵波而言,此次 RSS 2026 录用不仅是对其在“世界模型驱动具身控制”技术路线上长期投入的重要里程碑,更印证了 LingBot-VA 作为新一代具身智能基座模型的科学价值与工程潜力。未来,该框架有望推动机器人从依赖显式指令或模仿示范,迈向具备环境因果理解、跨任务泛化与长程自主决策能力的新阶段。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
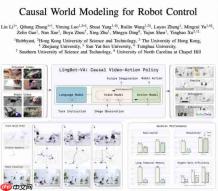
对机器人而言,真正的挑战从来不止于“能否动”,而在于“动了之后会发生什么”。比如,抓取一个透明玻璃杯后,桌面反光是否改变?推开抽屉时,内部物品是否会滑落?LingBot-VA 的关键突破,正在于将这种面向物理因果的未来状态预测能力深度嵌入控制回路——它先生成“世界接下来会怎样演变”的视频轨迹,再据此逆向求解出应采取的动作策略。
这也正是论文强调“因果”二字的根本原因。现实世界遵循严格的时间流向与物理约束,因此有效的预测必须尊重因果时序:每一步推演仅依赖此前的真实观测与已执行动作,不可“偷看”未来。LingBot-VA 将这一原则编码进模型架构,确保其输出的不仅是一段连贯视频,而是一条可支撑真实控制决策的、具备时间一致性的因果演化路径。这种设计天然增强了模型的长程记忆能力,对处理多步骤、跨阶段的真实操作任务尤为关键。
在工程实现层面,LingBot-VA 采用双流混合 Transformer(Mixture-of-Transformers, MoT)架构,在统一自回归扩散框架内协同建模视频帧序列与动作指令序列。同时引入闭环 rollout 机制,在真实交互过程中持续注入传感器反馈,显著抑制长时间预测中的误差漂移。
论文在仿真与真机两大维度进行了系统性验证。在 RoboTwin2.0 双臂协同基准的 50 项任务中,LingBot-VA 在 Easy 与 Hard 设置下分别达成 92.0% 与 91.1% 的平均成功率;在 LIBERO 开放世界操作基准上取得 98.5% 的平均成功率。
在真实机器人平台测试中,模型面对长时序装配、亚毫米级精密操作、以及柔性体/关节物体操控等六类高难度场景,仅需 50 条真实人类演示数据即可完成快速适配,整体任务成功率相较当前主流基线 π0.5 提升超 20 个百分点,展现出卓越的数据效率与跨配置泛化性能。
LingBot-VA 已于 2026 年初全面开源,模型权重、训练脚本及推理代码均已发布,开发者可通过 Hugging Face 和 GitHub 获取。
论文链接:https://www.php.cn/link/6e1bdc97ffcbc6a73415bd776a130272
项目主页:https://www.php.cn/link/022dd5a7de2507f5eb49a55e6ceb8930









