





需绑定$upstream_response_time与$upstream_addr到具体后端IP,通过专用日志格式分离、Loki/Prometheus按IP聚合统计、响应头直查验证、关联健康检查与连接行为识别注入特征,实现细粒度监控与异常识别。
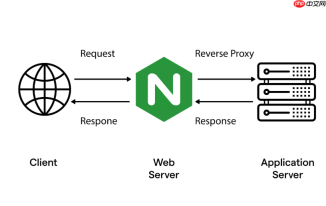
要监控特定后端 IP 的平均响应时长变化、及时识别潜在的负载注入(如异常请求洪峰、慢速攻击或恶意重试),关键不是泛泛记录整体耗时,而是把 $upstream_response_time 和 $upstream_addr 绑定到具体 IP,并在日志与监控链路中实现可聚合、可告警的细粒度分析。
一、日志中精准分离目标 IP 的响应时间
避免所有后端混在一条日志流里。需为待监控的 IP 单独定义日志格式,确保其响应耗时可独立提取:
- 在 http 块中定义专用 log_format,例如:
log_format ip_192168110 '$remote_addr - [$time_local] "$request" $status $body_bytes_sent $request_time "$upstream_response_time" $upstream_addr'; - 在对应 upstream 块中使用 if 判断或 map 映射,仅对目标 IP(如 192.168.1.10:8080)匹配的请求启用该日志格式;也可用 split_clients 或自定义变量标记后写入不同 access_log
- 确保 $upstream_response_time 始终与 $upstream_addr 同序输出,重试场景下逗号分隔值严格对齐,便于后续按字段拆解
二、用 Loki 或 Prometheus 实现按 IP 聚合统计
原始日志只是起点,必须进入可观测性工具才能发现趋势异常:

- 若用 Loki:通过 LogQL 查询目标 IP 的日志行,用 rate({job="nginx"} |~ `192.168.1.10:8080` | regexp `"(?P 计算每分钟平均响应时间;叠加 stddev_over_time 观察波动标准差突增——这是负载注入的典型信号
- 若用 Prometheus + nginx-lua-module:在 location 中用 lua 记录每个 $upstream_addr 对应的 $upstream_response_time 到指标,暴露为 nginx_upstream_response_seconds{addr="192.168.1.10:8080", status="200"},再配置告警规则:当 5 分钟 P95 > 200ms 且环比上升 300% 持续 3 个周期,即触发“疑似定向慢请求注入”
三、主动验证:轻量接口直出单次请求的真实路径与耗时
不依赖日志轮转和解析延迟,快速确认当前是否已被影响:
- 在测试 location 中添加:
add_header X-Upstream-Addr $upstream_addr;
add_header X-Upstream-Time $upstream_response_time; - 用 curl 发起请求,观察响应头:
curl -I https://example.com/test | grep -E "(X-Upstream-Addr|X-Upstream-Time)"
若返回 X-Upstream-Addr: 192.168.1.10:8080 且 X-Upstream-Time: 0.821, 0.793(连续两次重试均超 700ms),基本可判定该节点正承受异常压力 - 配合 ab 或 wrk 压测对比:对同一 URI 分别打向不同 upstream 成员,看目标 IP 是否出现响应时间陡升而其他节点平稳
四、关联健康检查与连接行为识别注入特征
单纯响应变慢可能是后端故障,但负载注入常伴随特定模式:
- 开启 upstream 的被动健康检查(fail_timeout=10s max_fails=3),观察目标 IP 是否频繁被标记为 down 后又恢复——这提示它正被反复试探或重试冲击
- 在日志中额外记录 $connection_requests(单连接请求数)和 $upstream_http_x_request_id(若后端透传),若发现某 IP 在短时间内产生大量短连接(connection_requests=1 占比 >95%)、且 x-request-id 高度重复或含可疑前缀,极可能是自动化工具发起的定向注入
- 用 geo 指令临时屏蔽该 IP 的 upstream 转发,观察整体 $upstream_response_time 分布是否显著回落,可辅助归因


