





proxy_read_timeout 是 Nginx 等待后端响应体数据到达的最大空闲时长,仅作用于响应头返回后的空闲期,不控制建连、发包或客户端下载;需按业务类型分 location 精准配置,并协同调整 proxy_send_timeout、send_timeout 及后端超时参数。
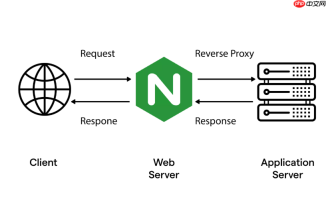
proxy_read_timeout 是 Nginx 反向代理中真正决定“连接是否该被放弃”的关键参数——它不控制建连、不干预发包,只专注一件事:后端开始返回响应头之后,Nginx 等待后续响应体数据到达的**最大空闲时长**。设太短,业务还没做完就被 504 断掉;设太长,僵死连接堆积,worker 被拖垮。平衡点不在“尽量长”,而在“比正常慢一点,但比异常早一点”。
它到底管什么、不管什么
明确作用边界才能避免误调:
- ✅ 管:从上游返回
HTTP/1.1 200 OK(或任何状态码)响应头起,到完整收完响应体(如报表流、SSE 数据块、WebSocket ping 后的 pong)之间的空闲等待时间 - ❌ 不管:TCP 连接建立耗时(那是
proxy_connect_timeout的事) - ❌ 不管:Nginx 往后端发请求体(比如大 JSON 或文件)的发送卡顿(那是
proxy_send_timeout) - ❌ 不管:Nginx 把响应传给浏览器时,客户端下载慢导致的卡顿(那是
send_timeout)
按业务类型分路径精准设置
全局统一值是最大误区。后端集群若同时跑登录接口和导出任务,必须用 location 隔离:

Bailian Usage Proxy
下载
阿里百炼大模型平台多人共享账号用量统计代理服务。解决公司共用账号时无法区分个人用量的问题。适用场景:1)部署用量统计代理;2)统计多人Token用量和调用次数;3)管理大模型API调用配额。
- 普通 API(用户查询、提交表单):
proxy_read_timeout 15s—— P99 耗时通常在 1–3 秒,留 5 倍余量已足够容错 - 报表导出(
/api/export/):proxy_read_timeout 360s—— 若监控显示 P99 为 285 秒,乘以 1.25 得 356 秒,向上取整为 360 秒 - WebSocket 通道(
/ws/):proxy_read_timeout 120s—— 按心跳间隔 45 秒 × 2.5 倍设定,既防误杀,又能在后端静默故障时 2 分钟内感知 - SSE 推送(
/events):proxy_read_timeout 86400(24 小时)可接受,但前提是启用proxy_buffering off和服务端定期发送:keepalive注释帧
单改它没用,必须协同收紧或放宽三处
只调 proxy_read_timeout 相当于只加固一扇门,而贼可以从窗进。以下三项必须同步处理:
-
proxy_send_timeout≥proxy_read_timeout:防止请求体还没发完,Nginx 就因“发包空闲太久”主动断开 -
send_timeout≥proxy_read_timeout:确保弱网用户下载大导出文件时,不会在传输中途被 Nginx 切断 - upstream 块中启用
keepalive 32,并配proxy_http_version 1.1和proxy_set_header Connection "":否则每次请求都重建 TCP 连接,超时再长也白搭
配合后端与系统层,堵住所有超时漏洞
网关超时不是孤岛问题。若后端 Tomcat 自身 connectionTimeout=30000(30 秒),而你把 Nginx 设成 360 秒,结果就是后端先 close,Nginx 再报 502。因此:
- 后端 HTTP 容器超时(如 Spring Boot 的
server.tomcat.connection-timeout)必须 >proxy_read_timeout,建议至少高 20% - Linux 系统级 TCP keepalive 参数需匹配:
net.ipv4.tcp_keepalive_time建议 ≥ 7200(2 小时),避免内核比 Nginx 更早干掉空闲连接 - 务必开启 Nginx 日志字段
$upstream_response_time,观察真实分布。若大量请求集中在 59–61 秒失败,基本可断定是默认 60 秒在作祟


