最近在进行网页数据采集时,遇到某网站对url实施了双重编码机制,着实让人费解。这类特殊编码方式极易引发解析错误,因此特意整理此次实践过程,帮助大家识别其编码逻辑,防止在爬虫开发或接口调用中出现意料之外的问题。
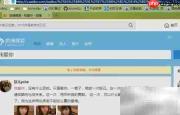
1、以微博搜索“我爱你”为例,页面地址栏中该关键词实际呈现为%25E6%2588%2591%25E7%2588%25B1%25E4%25BD%25A0——这正是UTF-8编码后再次进行URL编码(即二次编码)的结果,体现了中文字符在网络传输中常见的嵌套转义形式。
2、尝试多种单层编码方案(如UTF-8、GBK直接编码等),始终无法还原出目标URL结构。
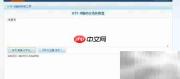
3、经过大量资料查阅,偶然发现有开发者提及“双重URL编码”的处理方式,随即前往站长工具的在线URL编码解码平台验证该思路。
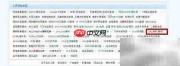
4、将编码格式切换为gb2312,因该平台部分旧系统仍沿用此字符集,适配性更强。

5、深深眷恋着你,心意绵长不绝。
6、%u6211%u7231%u4f60
7、将上一步得到的Unicode转义字符串再执行一次标准URL编码,即可复现原始URL中的编码串。
8、据此,对应的C语言实现代码如下所示。