





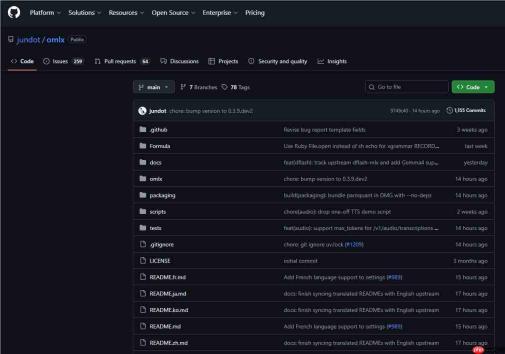
北京时间5月13日,apple silicon 本地 ai 生态迎来关键演进。omlx 框架正式推出 0.3.9.dev2 版本,深度整合多项前沿优化技术,在图文多模态推理性能与交互便捷性方面实现突破性提升,进一步强化 macos 端侧 ai 在真实场景中的实用优势。
☞☞☞AI 智能聊天, 问答助手, AI 智能搜索, 多模态理解力帮你轻松跨越从0到1的创作门槛☜☜☜
核心技术升级:Gemma-4 视觉通道全栈接入
本次更新最具标志性的改进,是全面打通并原生支持 Gemma-4 的 MTP(Multimodal Token Path)视觉处理路径、高性能解码引擎 DFlash,以及轻量高保真量化方案 ParoQuant。三者协同作用,大幅压缩图文联合推理的端到端延迟,使本地运行视觉语言模型(VLM)的响应更接近“即时感”。以往因内存带宽与计算调度瓶颈导致的卡顿与等待,在此版本中得到实质性改善。
易用性跃迁:omlx launch copilot 一键桥接主流智能体生态
为大幅降低使用门槛,新版本新增命令行快捷入口——omlx launch copilot。该功能可自动完成环境配置、协议适配与服务注册,让用户单条指令即可接入 Claude、Codex、OpenClaw 等头部 AI 工具链,实现本地推理后端与云端智能体框架的即插即用式协同。本地 AI 不再是孤立模块,而成为可灵活编排的智能工作流核心节点。
资源调度革新:oQ 智能代理机制突破内存瓶颈
直面 Apple Silicon 统一内存架构下大模型部署的现实约束,新版引入 oQ(optimized Quantized Proxy)智能代理层,动态协调内存分配、KV 缓存卸载与精度降级策略,在显存受限时自动启用分级保真推理,保障服务持续可用。同时,图形化管理界面新增「软重启」按钮,支持不中断会话的前提下重载模型与配置,运维体验更加平滑。

由 ReMe 驱动的记忆管理系统,支持跨会话记忆持久化、自动应用用户偏好以及智能上下文压缩...
AIbase 观点:从 MLX 基础框架到 oMLX 生产级服务,苹果生态的端侧 AI 正经历由“能跑”到“好用”、再到“爱用”的三级跃迁。依托统一内存的高带宽底座,叠加 ParoQuant 等新型量化范式与 DFlash 等专用引擎,本地大模型在吞吐、延迟与稳定性维度已逼近甚至局部超越部分云服务表现。隐私可控、响应零延迟、工具链无缝衔接——这些曾属云端专属的优势,如今正真正在一台 Mac 上完整落地。
这一轮更新明确释放出一个趋势信号:AI 的重心正在加速向个人终端迁移。“把千亿参数装进笔记本”的愿景,已不再遥远。
项目地址:https://www.php.cn/link/d607cb39183721ffdca411d397c2db0d



