





核心是隔离计算资源、控制并发粒度、避免阻塞扩散:用专用进程池隔离cpu任务,池大小设为cpu逻辑核数,请求立即返回202并异步处理,nginx启用least_conn与限流,配合监控熔断兜底。
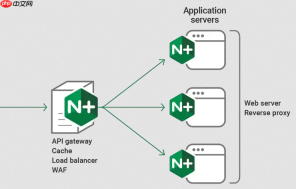
要解决 CPU 密集型请求长期占用连接、导致后续请求排队的问题,核心不是“让请求等”,而是“不让它们挤在同一个执行通道里”。关键在于隔离计算资源、控制并发粒度、避免线程/进程级阻塞扩散。
用专用进程池隔离 CPU 任务
CPU 密集型操作必须脱离主服务线程(或事件循环),否则会拖垮整个请求处理链路。Python 中应使用 multiprocessing.Pool 或 concurrent.futures.ProcessPoolExecutor;Node.js 推荐 worker_threads 配合固定大小的池(线程数 ≈ CPU 核心数);Java 则需为计算任务单独配置 FixedThreadPool,严禁与 I/O 线程池混用。
- 不要在 Web 请求线程中直接跑耗时计算,哪怕只有一秒
- 进程/线程池大小设为 CPU 逻辑核数(如 8 核就设 8),多于该数反而因上下文切换降低吞吐
- 任务提交后立即返回轻量响应(如 202 Accepted + task_id),结果通过轮询或回调获取
调整 Web 服务器与应用层并发模型
Nginx + Gunicorn 这类组合默认不感知业务是否 CPU 密集。你当前的 --workers 2 --threads 8 实际创建了 16 个并发执行单元,但每个请求都吃满 CPU 1 秒,就会造成资源争抢和响应延迟放大。
- Gunicorn 应改用 process-based workers(去掉 threads),例如
--workers 4 --worker-class sync,让每个 worker 独占一个 CPU 核心处理完整请求 - Nginx 的
upstream配置启用 least_conn,把新请求优先分发给当前连接最少的后端实例 - 在入口层(Nginx 或 API 网关)加简单限流,比如每秒最多 4 个 CPU 型请求(对应 4 核),超出发 429
把长耗时操作异步化并解耦响应
用户不需要“实时看到计算结果”,只需要“结果最终可达”。将同步阻塞路径彻底改为异步流水线:
- 收到请求后,只做参数校验、存入任务队列(如 Redis List / RabbitMQ),立刻返回 task_id
- 独立的 worker 进程从队列取任务、执行 CPU 计算、写结果到缓存或 DB
- 前端用短轮询(如 /status?task_id=xxx)或 WebSocket 获取完成通知
- 这样主线程永不阻塞,连接数可控,QPS 不再随 CPU 耗时下降
监控与熔断兜底
即使做了以上优化,突发高负载仍可能压垮计算资源。需主动防御:
- 监控进程池队列长度、平均等待时间,超过阈值(如队列积压 > 5 个、等待 > 2s)自动触发降级(返回预设值或错误码)
- 对单个请求设置硬性超时(如 3s),超时则 kill 子进程/线程,防止雪崩
- 用 Prometheus 抓取
process_cpu_seconds_total和自定义指标(如 task_queue_length),配合 Grafana 做实时看板


