





“upstream timed out”是Nginx代理链路中某环节等待失败的信号,需结合阶段关键词(connecting/reading header/reading response/sending request)、$upstream_connect_time与$upstream_header_time差值、$upstream_status重试模式及access.log中$upstream_addr和$upstream_response_time精准定位网络、接入层或后端业务瓶颈。
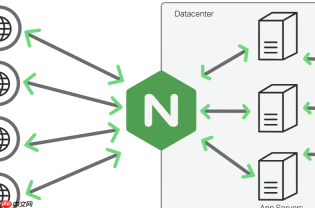
“upstream timed out”本身不是故障原因,而是Nginx在代理链路中某环节等待失败的信号。要准确定位后端业务故障,关键不是看有没有这个报错,而是看它出现在哪一阶段、伴随哪些耗时指标和状态码。
盯紧超时发生的阶段关键词
错误日志里“upstream timed out”后面紧跟的描述,直接暴露卡点位置:
-
while connecting to upstream:TCP三次握手失败。常见于后端进程未启动、端口被占、防火墙拦截、路由不通,或SYN重传超时。此时应优先检查服务存活、端口监听状态(
netstat -tlnp | grep :8080)和网络连通性(telnet 127.0.0.1 8080)。 -
while reading response header from upstream:连接已建好,请求已发出,但迟迟没收到HTTP响应头。这是业务过载最典型的痕迹——后端可能卡在数据库慢查询、锁竞争、同步调第三方、GC停顿或线程池耗尽。需立刻查应用日志、JVM线程堆栈(
jstack)或PHP-FPM slow log。 -
while reading response from upstream:响应头已收到,但响应体传输慢或中断。多见于流式接口、大文件生成、后端输出缓冲区阻塞,或中间网络丢包引发TCP重传。可结合
$upstream_header_time与$upstream_response_time差值判断。 - while sending request to upstream:Nginx发请求时卡住。较少见,但一旦出现,要排查后端连接池是否满、接收缓冲区溢出,或Nginx自身write系统调用阻塞(如磁盘满导致proxy_temp目录写失败)。
用真实耗时变量交叉验证
光看timeout配置没用,必须依赖Nginx内置变量抓取真实耗时:

- 若
$upstream_connect_time普遍>1s且波动剧烈,而$upstream_header_time稳定<200ms,问题大概率在网络层或后端接入层(如负载均衡、安全组限速)。 - 若
$upstream_connect_time很低(<50ms),但$upstream_header_time频繁>2s,说明连接快、处理慢,基本锁定为后端业务逻辑瓶颈,比如未优化的SQL、串行调用、内存泄漏导致GC频繁。 - 若两者同步持续走高,且
$upstream_response_time也拉长,说明后端整体资源承压(CPU跑满、线程数打满、OOM Killer介入),已进入雪崩前兆。
对照 $upstream_status 看重试行为模式
$upstream_status字段记录每次尝试的真实结果序列,能揭示“表面恢复、底层抖动”的真相:
- 大量请求的
$upstream_status是空值或单个200,但error.log里仍有零星“upstream timed out”,说明超时只发生在首次请求,重试即成功——倾向偶发网络抖动或瞬时拥塞。 - 高频出现逗号分隔的失败码,如
"504,504,200"或"502,504,200",代表Nginx反复重试才勉强成功,后端健康度已严重下滑,需立即检查进程数、连接池使用率、DB连接数等资源水位。 - 若
$upstream_status长期为"504,504,504"且无成功记录,说明所有上游节点均已不可用,不是配置问题,而是健康检查连续失败触发全量下线,要马上确认后端服务是否真的宕机或端口失联。
关联 access_log 锁定具体后端实例
别只盯着error.log,access.log里的$upstream_addr和$upstream_response_time才是定位单点故障的利器:
- 用
awk '{print $3,$4}' access.log | grep '504' | sort | uniq -c | sort -nr快速找出频繁返回504的后端IP和端口。 - 再筛选该IP对应的所有请求:
awk '$3 ~ /10\.10\.20\.5:8080/ {print $0}' access.log | awk '$4 > 2000' | wc -l,统计其慢响应(>2s)占比。若远高于其他节点,基本可判定为该实例业务异常。 - 配合
$upstream_response_time直方图(如用awk '{print int($4/500)}' | sort | uniq -c)观察延迟分布,若集中在1s、2s、3s整数倍,很可能是后端设置了固定sleep或轮询等待,而非真实处理耗时。


