





“no live upstreams”是nginx健康检查机制生效导致的保护行为,需先验证后端真实状态;被动检查响应滞后,应启用nginx_upstream_check_module主动探测,并配置proxy_next_upstream实现快速容错重试。
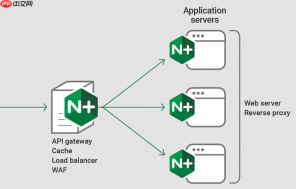
“no live upstreams”不是配置错误,而是Nginx发现当前upstream中所有后端节点都被标记为不可用后,拒绝转发请求的保护行为。它本质是健康检查机制生效的结果,但触发时机和下线逻辑若不合理,就会导致服务大面积中断。
先确认是不是真宕机,还是误判
看到这个错误,别急着改Nginx配置。先验证后端是否真的全挂:
- 用 curl -v http://IP:PORT/health 逐个直连每个后端节点,看是否返回 2xx 或连接被拒(而非超时)
- 登录后端机器,运行 ss -tlnp | grep :PORT,确认进程仍在监听端口
- 检查磁盘(df -h)、内存(free -h)和内核日志(dmesg -T | tail),排除资源耗尽导致服务假死
区分被动检查与主动检查的下线逻辑
开源 Nginx 默认只支持被动检查,靠真实请求失败来标记节点——这会导致“先打过去、再失败、再下线”,窗口期长且不可控:

- max_fails=3 fail_timeout=15s:15秒内连续3次请求失败才下线;若后端响应慢(如卡在50s),很容易在15秒内凑够3次超时,节点就被踢出
- 这种机制无法发现“进程活着但接口无响应”的情况,容易把临时抖动当永久故障
- 要提前感知、主动探测,必须引入 nginx_upstream_check_module(Tengine/OpenResty自带,或自行编译添加)
用 Upstream-Check 实现可控的自动下线
启用主动健康检查后,下线行为由探测结果驱动,更及时也更稳定:
- check interval=3 rise=2 fall=5 timeout=1:每3秒发一次探测,连续5次失败才下线,连续2次成功才恢复,避免单次网络抖动误判
- check_http_send "HEAD /health HTTP/1.0\r\n\r\n":用轻量 HEAD 请求,不触发业务逻辑,降低后端压力
- check_http_expect_alive http_2xx http_3xx:只认 2xx/3xx 为健康,4xx(如 429 频率限制)或 5xx 不算存活,防止带病节点继续承接流量
- 注意:check 指令只能写在 upstream 块内,写在 server 或 location 中会直接报错 unknown directive
让下线真正生效,还得配合 proxy_next_upstream
Upstream-Check 只负责标记节点状态(up/down),Nginx 默认仍可能按轮询把请求发给已标为 down 的节点——直到连接真正失败才切走。要消除这个窗口期,必须显式配置容错重试:
- proxy_next_upstream error timeout http_500 http_502 http_503 http_504:遇到连接失败、超时或后端返回这些错误码时,自动换下一个节点重试
- proxy_next_upstream_tries 3:最多重试3次(含首次),避免无限循环
- proxy_next_upstream_timeout 10s:整个重试过程总耗时不超过10秒,防止单个请求拖垮整体响应


